[CS][OS] Virtualization - Paging
이 글은 Andrea Arpaci-Dusseau and Remzi Arpaci-Dusseau의 Operating Systems: Three Easy Pieces를 참고한 글입니다.
여기에서 무료로 볼 수 있습니다.
0. Introduction
앞서 본 segmentation은 address space를 가변 크기의 작은 공간으로 나눠 관리하기 때문에 물리 메모리를 유연하게 관리할 수 있다는 장점이 있다. 그러나 이런 방식은 framentation의 위험성을 증가시킨다. 물리 메모리가 작은 공간으로 나뉘어 할당되기 때문에 큰 크기의 segment가 필요할 때 연속된 공간이 부족해 할당이 실패할 수 있다는 것이다. 이를 해결하기 위해서는 처음 살펴봤듯 메모리를 고정 크기로 나눠 할당할 필요가 있는데, 이를 위해 paging이 등장했다.
1. Paging
1-1. PFN
Paging에서 말하는 page란, 물리 메모리를 고정된 사이즈로 나눈 조각이라 생각하면 된다. 예를 들어, 전체 물리 메모리가 64KB이고 page 크기가 4KB라면, OS는 물리 메모리를 16개의 page(16 * 4KB = 64KB)로 나눠서 관리한다. 이때 각 page에는 구분을 위해 숫자가 붙는다. 앞서 예시로 든 상황에서는 0번부터 15번까지 번호가 붙는 것이다. 이렇게 붙은 번호를 page의 PFN(Physical Frame Number)라 한다.
1-2. VPN
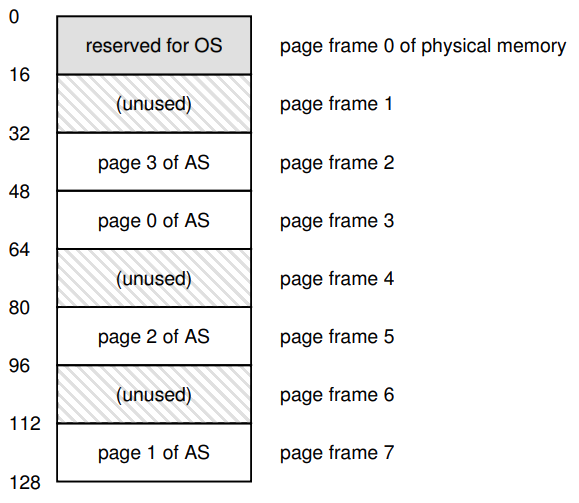
예시를 위해, 64B address space를 가정하고, 전체 물리 메모리는 128B라고 가정하자. Page 사이즈는 16B로 한다. 그렇다면, OS는 물리 메모리를 다음과 같이 8개의 page(16 * 8 = 128)로 나눠 관리할 것이다.
마찬가지로 process의 address space는 다음과 같이 4개의 page로 이루어진다고 생각할 수 있다. (16 * 4 = 64)
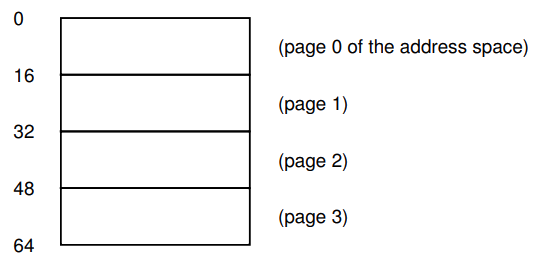
이때 해당 address space 안에서의 page 번호를 VPN(Virtual Page Number)이라 한다. 위의 상황에서는 VPN이 0번부터 3번까지 존재하는 것이다.
1-3. Address Translation
위의 그림으로부터, 우리는 이제 프로세스기 특정 메모리에 접근하려고 했을 때 OS는 다음과 같은 행동을 해야 한다고 생각해볼 수 있다.
- 해당 메모리 주소가 몇 번째 page에 속하는지 판단
(즉, 해당 주소에 속하는 page의 PFN을 확인) - VPN을 PFN으로 변환
- 얻은 PFN을 통해 가상 주소를 실제 주소로 변환하고 메모리에 접근
여기서 중요한 것은 1번이다. 만약 segmentation과 같이 base-and-bounds 접근을 사용한다면 page 개수만큼 레지스터가 있어야 하기 때문에 불가능한 방법이다. 따라서 주소 자체에 해당 메모리 주소의 VPN을 넣는 방법이 고안되었는데, 방법은 다음과 같다.
우선, 우리는 64B address space를 사용하고 있기 때문에 VA는 다음과 같이 6비트일 것이다.
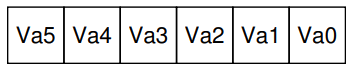
이때, address space는 4개의 page로 이루어져 있다는 점을 고려하면 다음과 같이 상위 2개 비트를 VPN으로 사용하고, 나머지를 offset으로 사용하는 방식을 고려해볼 수 있다.
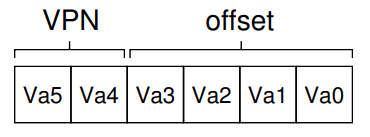
이렇게 하면, 가상 주소를 통해 모든 page를 나타낼 수 있고 ($2^2=4$) page 안의 모든 주소에도 접근할 수 있다 ($2^4=16$).
예를 들어, 가상 주소 21을 물리 주소로 바꾼다고 하자. 21 = 0b010101임을 고려하면, 다음과 같이 이 주소의 VPN=1, offset=0101임을 알 수 있다. 이때 VPN=1은 PFN=7로 변환되므로 (앞의 그림을 참고하자) 최종 물리 주소는 0b1110101이 된다.
1-4. Page Table
앞서 예시로 든 주소 변환 과정에서, VPN이 PFN으로 변환되는 부분이 있었다. 예시 그림을 다시 보면, 각 VPN별로 다음과 같은 변환이 일어나야 함을 알 수 있다.
- VPN=0은 PFN=3으로 변환
- VPN=1은 PFN=7으로 변환
- VPN=2은 PFN=5으로 변환
- VPN=4은 PFN=3으로 변환
이를 변환하기 위해 OS는 page table을 만들어 커널 메모리에 저장해 두고, 주소 변환이 필요할 때마다 이를 참조해 변환한다.
참고
Page table은 per-process여야만 한다.
이때 page table에는 단순히 VPN과 PFN만이 저장되는 것이 아니다. 여기에는 해당 page가 읽기 가능한지, 쓰기 가능한지, 실행 가능한지에 대한 정보와 해당 page가 실제로 메모리에 있는지 등의 정보가 들어간다. 이렇게 여러 정보가 들어간 page table의 entry들을 PTE(Page Table Entry)라 하며, 이에 대해서는 뒤에서 더 자세히 알아보도록 한다.
또한 page table도 메모리에 저장된 자료이기 때문에, 주소 변환이 일어날 때 page table이 저장된 물리 메모리의 주소를 알 수 있어야 한다. 이를 위해 레지스터가 하나 추가로 사용되며, 항상 page table의 base 주소를 가리키도록 설정된다. 이를 page table base register라 부른다.
지금까지의 변환 과정을 슈도코드로 나타내면 다음과 같다.
VPN       = (VA & VPN_MASK) >> VPN_SHIFT
// 여기서는 page table이 array처럼 저장되어 있다고 가정한다.
PTE_addr  = PTBR[VPN]
PFN       = get_PFN(PTE_addr)

offset    = (VA & OFFSET_MASK)
PA        = (PFN << VPN_SHIFT) | offset
예를 들어, 앞서 말한 상황에서 가상 주소 21을 물리 주소로 바꾼다고 하자.
21 = 0b010101임을 고려하면,
VPN = (0b010101 & 0b110000) >> 4 = 0b01 = 1PFN = get_PFN(PTBR[1]) = 111offset = (0b010101 & 0b001111) = 0b0101PA = (0b111 << 4) | 0b0101 = 0b1110101
이 되어 앞서 말한 것처럼 성공적으로 주소 변환이 일어남을 알 수 있다.
2. TLB
앞서 말한 방법은, 가상 주소에 접근할 때마다 총 3번의 메모리 접근(page table 접근, PTE 접근, 최종 물리 주소 접근)이 일어나고, 따라서 원래 메모리 접근에 비해 300% 이상의 오버헤드가 발생하게 된다. 만약 메모리에 접근할 때마다 이렇게 큰 오버헤드가 발생한다면 paging은 쓸 수 없을 것이다. 이를 해결하기 위해, OS는 MMU 안의 TLB(Translation-Lookaside Buffer)라는 하드웨어의 도움을 받는다.
TLB는 단순히 말하면 page table의 cache라고 할 수 있다. Address translation 도중 page table에 접근이 발생하면, TLB는 해당 요청과 결과를 저장한다. 예를 들어, 앞서 든 예시에서 VPN=1이 PFN=7로 변환되었기 때문에 TLB는 이를 저장하게 된다. 향후 다시 VPN=1을 PFN으로 바꿀 일이 있으면, MMU는 page table에 접근하는 대신 TLB를 통해 이를 PFN으로 변환하게 된다. 이 과정을 대략 코드로 표현하면 다음과 같다.
VPN       = (VA & VPN_MASK) >> VPN_SHIFT
TLB_PFN   = TLB_lookup(VPN)

if (TLB_PFN == -1) {
    // TLB에 cache되지 않은 VPN이므로 page table에 접근해
    // PFN을 가져온다.
    VPN       = (VA & VPN_MASK) >> VPN_SHIFT
    PTE_addr  = PTBR[VPN]
    PFN       = get_PFN(PTE_addr)
    TLB_insert(VPN, PFN)
    // 해당 가상주소에 대한 접근을 다시 실행하면
    // 이제는 TLB에 해당 VPN이 cache되었기 때문에
    // 정상적으로 작동할 것이다.
    retry_access(VA)
}

offset    = (VA & OFFSET_MASK)
PA        = (TLB_PFN << VPN_SHIFT) | offset
이때, 요청한 VPN에 대한 정보가 TLB에 cache되어있을 때 이를 TLB hit라 하고, cache되어있지 않은 경우를 TLB miss라고 한다. 또한 전체 요청에 대한 TLB hit의 비율을 TLB hit rate라 한다. 당연하게도 TLB hit이 많으면 많을수록(즉, TLB hit rate가 높으면 높을수록) address translation 과정이 빠르게 일어나기 때문에, TLB를 설계할 때의 목적은 TLB hit rate을 최대화하는 것이 된다.
참고
TLB는 locality에 기반하여 만들어졌다. Locality는 다음과 같이 2개로 나뉜다.
- Temporal locality는 “방금 전 접근한 메모리는 또 접근할 확률이 높다”로, 방금 접근된 page는 다시 접근될 확률이 높다는 것이다.
예를 들어, 대부분의 프로세스는 조건 분기가 복잡하게 되어있지 않은 한 instruction fetch 단계에서 방금 접근한 instruction의 다음 instruction을 읽어올 것이고, 이 둘은 같은 page에 속할 확률이 높다. 만약 프로그램이 매우 작아 한 page안에 들어가거나, page의 크기가 충분히 커 프로그램이 한 page 안에 들어온다면 temporal locality에 의해 hit rate가 크게 상승할 것이다.- Spatial locality는 “방금 전 접근한 메모리 주변에 접근할 확률이 높다”는 것이다.
예를 들어, 배열을 다루는 상황에서는 한 원소가 접근되면 그 주변의 원소도 접근될 확률이 높을 것이다. 이때 그 주변의 원소도 같은 page에 속한다면 실제로 그 원소에 접근했을 때 hit rate가 상승할 것이다.결국 두 locality의 본질은 비슷하나, 이러한 이유로 TLB가 아무리 대충 만들어도 address translation 과정의 성능을 크게 향상시킨다는 점만 알아두자.
참고
TLB에는 (VPN, PFN) 쌍 말고도 권한에 대한 정보 등 PTE와 비슷하게 여러 정보들이 저장된다. 이는 나중에 살펴보겠지만, 지금은 해당 TLB의 entry가 유효한지를 알려주는 valid bit 정도가 있다는 것만 알아두자.
2-1. ASID
그렇다면 여러 프로세스가 실행되고 있는 상황에서 TLB는 어떻게 관리될까? 앞서 말했듯, page table은 per-process이기 때문에 context switch가 일어날 때 OS에 의해 page table base register가 업데이트되어야 했다. 그러나 TLB는 page table과 달리 하나밖에 없기 때문에, context switch 이후에도 이전 process의 TLB가 남아있다면 다른 process의 메모리에 접근하는 상황이 발생할 수 있기 때문에 주의가 필요하다.
가장 쉬운 방법은, context switch가 일어날 때 TLB를 flush하는 방법일 것이다. 즉, context switch가 일어나면 TLB의 모든 entry의 valid bit을 0으로 만들면 된다. 이렇게 되면 새로 실행권을 얻은 process가 같은 주소에 접근하더라도 valid bit이 0이기 때문에 실제 page table에 접근이 일어날 것이고, 성공적으로 TLB가 업데이트될 것이다.
그러나 현대 OS는 context switch가 매우 빠르게 일어난다는 것을 고려하면, TLB를 flush하는 방법은 굉장히 오버헤드가 클 것이다. 이를 위해, TLB는 운영체제의 PID와 비슷하게 ASID(Address Space IDentifier)를 사용해 어떤 process가 어느 TLB entry에 접근해야 하는지를 구분한다. 예를 들면, 다음과 같다.
| VPN | PFN | ASID |
|---|---|---|
| 10 | 100 | 1 |
| 10 | 170 | 2 |
위와 같은 경우에서, ASID 1을 쓰는 process(P1이라 하자)와 ASID 2를 쓰는 process(P2라 하자)는 둘 다 VPN=10에 접근할 수 있다. 그러나 이 둘은 ASID가 다르기 때문에, P1이 VPN=10에 접근하면 자동으로 PFN=100에 접근하게 될 것이고, 마찬가지로 P2가 VPN=10에 접근하면 PFN=170에 접근하게 될 것이다.
이러한 방식을 쓰면, 다음과 같이 다수의 프로세스가 메모리를 공유할 수 있다는 장점이 있다.
| VPN | PFN | ASID |
|---|---|---|
| 10 | 100 | 1 |
| 20 | 100 | 2 |
리눅스 같은 경우, 이런 방식을 통해 shared library를 구현한다. 예를 들어, libc를 생각해보자. 만약 libc가 실행되는 process만큼 메모리에 올라간다면, 상상도 못 할 만큼 메모리를 많이 차지할 것이다. 그러나 libc는 메모리에 한 번만 올라가고(위의 예시에서는 PFN=100), 각각의 process가 이를 공유하기 때문에 메모리를 크게 절약할 수 있다.
2-2. Multi-level Page Table
그러나 이러한 page table도 프로세스가 많아지게 되면 용량을 많이 차지하게 된다. 예를 들어, 64-bit 리눅스에서 page table이 차지하는 용량을 계산해 보자. 리눅스는 기본적으로 4KB page table을 채택하고 있기 때문에, 필요한 PTE 개수는 다음과 같다.
\[\#PTE = \frac{2^{64}}{2^2 \times 2^{10}} = 2^{52}\]만약 PTE의 크기가 4B라고 하면, 한 process의 page table은
\[2^{52} \times 2^2\text{Bytes} = 2^{54}\text{Bytes} = 16384 \text{TB}\]로, 말도 안 되게 커지게 된다. 이처럼 address space가 늘어남에 따라 커지는 page table 크기를 줄이기 위해 multi-level page table이 등장했다.
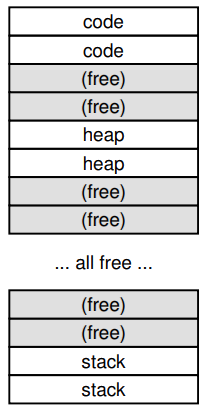
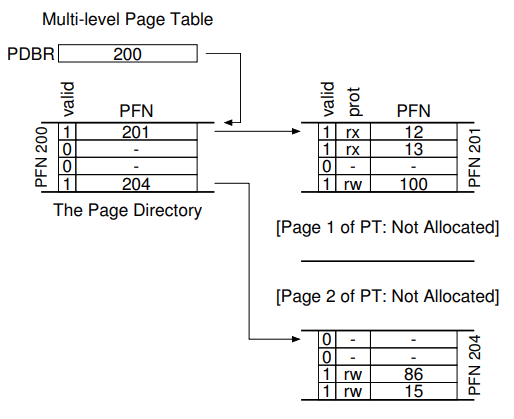
Multi-level page table은 기본적으로 segment와 함께 쓰인다. 앞서 segmentation에 대해 설명한 것을 상기해 보면, 위 그림처럼 segment와 segment 사이에는 사용하지 않은 공간이 많았다. 따라서 multi-level page table은 다음 그림과 같이 page table의 계층을 나누고 (여기서는 page directory - page table로 나눴다) 애당초 PTE가 존재하지 않는 page table은 할당을 하지 않는 방식으로 동작한다.
리눅스는 기본적으로 4-level page table을 사용한다. 자세한 내용에 관한 것은 이전에 썼던 글인 [Kernel Analysis] MM - Page Table 분석을 참고하자.
Leave a comment