[CS][OS] Virtualization - Memory: Address Space
이 글은 Andrea Arpaci-Dusseau and Remzi Arpaci-Dusseau의 Operating Systems: Three Easy Pieces를 참고한 글입니다.
여기에서 무료로 볼 수 있습니다.
0. Introduction
이전까지, 우리는 여러 process가 CPU를 공유하는 방법에 대해 알아봤다. 그러나 process가 동작하기 위해서는 CPU뿐만 아니라 메모리도 필요하다.
멀티프로그래밍이 대중화대기 이전의 OS들은, 메모리 관리에 대해 크게 걱정하지 않아도 됐다. 간단히 물리 메모리의 0KB부터 수십~수백 KB의 메모리를 OS가 사용하고, 나머지 공간을 하나의 프로세스에 할당하면 됐었다. 그러나 멀티프로그래밍이 등장하고, 여러 개의 process가 한 번에 돌아가기 시작하며 메모리를 잘 관리할 필요가 생겨났다.
1. Memory Sharing
다수의 process가 메모리를 공유할 수 있도록 하기 위해, 다음과 같은 기초적인 방법을 생각해볼 수 있다.
- OS는 0KB부터 수십~수백KB를 사용한다.
- 나머지 공간은 현재 running 상태인 process가 전부 사용한다.
- Running 상태인 process가 blocked나 ready 상태로 전환되면, 메모리 전체를 디스크 등 저장장치에 복사한다.
- 다음으로 schedule될 process의 저장된 메모리 상태를 디스크에서 불러 로드한다.
- 해당 process를 실행한다.
데이터를 디스크에 읽고 쓰는 작업이 굉장히 느리다는 점을 고려하면, 이 접근 방식은 I/O에 대부분의 시간을 빼앗기고 정작 process를 돌리는 데는 시간을 많이 쓰지 못할 것이다. 또한 process가 메모리 전체를 사용하는 일이 드물다는 점을 고려하면, 메모리 전체를 디스크에 저장하는 것은 굉장한 낭비이다. 따라서 메모리를 다음 그림과 같이 일정한 크기대로 나누고, process 하나당 한 블럭을 사용하게 하는 방식이 등장했다.
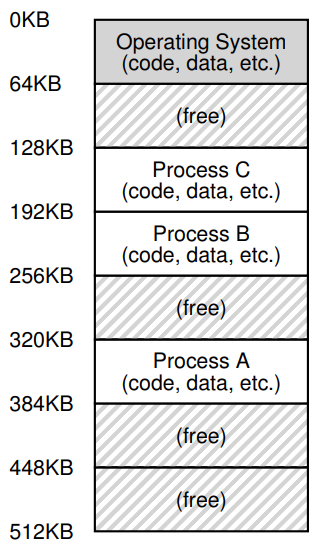
64KB로 나눈 경우이다.
2. Address Space
위 그림처럼 나누는 것은 좋지만, 만약 OS가 나누는 것 외에 아무런 기능도 추가하지 않는다면 각각의 process들은 특정 메모리에 접근하기 위해 자신이 할당된 주소를 알아야 한다. 예를 들어, 어떤 위의 그림에서 process A가 offset +0x1000에 있는 데이터에 접근하고 싶다면, 직접 320KB + 0x1000을 계산해 해당 위치에 있는 데이터를 읽어야 한다. 또한 만약 process A가 실수로(혹은 고의로) offset -100KB에 있는 데이터에 접근한다면 process B가 사용 중인 메모리에 접근하거나 이 값을 바꿔 process B에 오류가 생길 수 있다. 이런 문제점을 해결하기 위해 address space라는 개념이 등장했다.
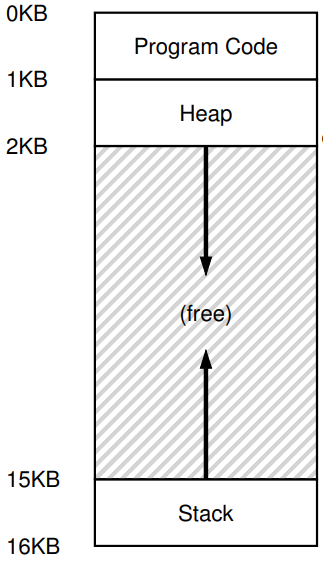
Address space는 각각의 process가 할당받는 독립된 가상 공간이다. 위의 그림에서는 address space의 크기가 16KB로 설정되어있다. Address space는 process가 동작하기 위한 대부분의 정보를 담고 있는데, 구체적인 내용은 다음과 같다.
Code영역은 instruction이 담겨있는 영역이다.Heap영역은 process 실행 중malloc()등을 통해 동적으로 할당된 메모리들이 존재한다.
Heap은 “아래로” 자란다는 점에 유의하자.Stack영역은 process 실행 중 지역변수와 리턴주소등을 담고 있는 함수의 stack frame에 사용된다.
Stack은 “위로” 자란다는 점에 유의하자.
참고
대부분의 운영체제는Code영역 아래 static data가 담겨 있는Data영역이 존재하지만 그림에는 표시되어있지 않다.
참고로 code 영역을 맨 위에 놓는 것은, code 영역의 크기는 항상 예측가능하고 바뀌지 않기 때문이다. 그러나 heap과 stack 영역은 그 크기가 정해져있지 않고 process 실행 중 동적으로 바뀌기 때문에, 최대한 자랄 수 있는 공간을 보장해주기 위해 양 끝에 위치시키고 서로를 향해 자라도록 한 것이다.
위에서 말했듯 address space는 process에게 할당된 독립된 가상 공간이기 때문에, process는 더 이상 위에서 말한 복잡한 계산을 할 필요가 없다. Process는 단순히 자신에게 “보이는” 메모리에 접근하면 되고 (예를 들어, 1.5KB에 있는 데이터에 접근한다고 하자) 이를 OS가 받아 해당 process의 물리 메모리 주소 + 1.5KB에 있는 데이터에 접근하는 식으로 동작하는 것이다. 이때 process가 접근하는 주소를
라고 한다.
3. Address Translation
그러나, OS가 주소 변환을 처리하면 엄청난 overhead가 필요할 것이다. 만약 주소 변환을 위해 계속해서 OS가 개입한다면 계속해서 context switch가 일어나며 엄청난 cost가 들 것이다. (여기서 ‘메모리 접근이 그렇게까지 많이 일어나나?’라고 의문을 가질 수도 있는데, process가 실행되기 위해서는 CPU가 메모리에 로드된 instruction을 fetch하는 과정이 필요하다. 다시 말해, 한 instruction당 최소 1번의 메모리 접근이 필요한 것이다!) 이를 해결하기 위해 scheduling에서 봤던 것처럼 하드웨어의 도움이 필요하다. 현대 CPU는 CPU 내부의 MMU(Memory Management Unit)를 통해 이를 구현한다.
3-1. Base-and-bounds approach
이를 위해, process에 할당된 address space의 물리 주소를 담고 있는 base와 bound register가 도입된다. 각각의 역할은 다음과 같다.
base: address space의 시작 물리 주소를 담고 있다.bound: address space의 끝 물리 주소를 담고 있다.
이때 base와 bound 레지스터를 일반 user process가 마음대로 수정할 수 있다면 이를 조작해 다른 process의 메모리를 조작하거나 심지어 OS가 사용 중인 메모리를 수정할 수 있게 된다. 이를 방지하기 위해, base와 bound register를 설정하는 instruction은 오로지 kernel mode에서만 사용할 수 있는 privileged instruction이다.
MMU는 base와 bound register에 저장된 정보를 다음과 같이 활용한다.
- 어떤 process가 특정 address에 접근하려고 한다. (이때 이 주소는 당연히 virtual address다.)
- MMU는 이 요청을 받아,
base + va를 계산해 실제 메모리 주소를 얻는다. - 만약
base + va >= bound라면, 해당 process에게 지정된 address space 이상을 읽으려는 것이기 때문에 오류를 일으키고 종료시킨다. - 아니라면, 해당 위치의 값을 읽어 process에 전달한다.
예를 들어, 특정 프로세스가 physical address 16KB에 address space를 배정받았고, address space의 크기는 총 4KB라고 하자. 이 상황에서 일어나는 translation의 예시는 다음과 같다.
| Virtual Address | → | Physical Address |
|---|---|---|
| 0 | 16KB | |
| 1KB | 17KB | |
| 3000 | 19384 | |
| 4400 | Fault |
이때, base와 bound는 컴파일 타임이 아니라 런타임에 하드웨어에 의해 동적으로 결정되게 된다. 이러한 특성 때문에, 이 방식은 dynamic relocation이라고 부르기도 한다.
Leave a comment