[CS][OS] Persistence - I/O Devices (HDD)
이 글은 Andrea Arpaci-Dusseau and Remzi Arpaci-Dusseau의 Operating Systems: Three Easy Pieces를 참고한 글입니다.
여기에서 무료로 볼 수 있습니다.
0. Introduction
일반적으로 OS는 전원이 종료된 이후에도 사용자의 데이터를 안전하게 저장해야 한다. 이를 위해 RAM과 같은 volatile 메모리가 아닌 HDD/SSD같은 non-volatile 메모리를 사용한다. 이렇게 비휘발성 메모리를 통해 사용자의 데이터를 전원이 꺼진 후에도 보관하는 것을
지속성 (Persistence)
이라 한다.
그렇다면 OS는 이러한 장치들을 어떻게 다룰까? 다시 말해, 사용자(혹은 커널)가 파일을 만들거나 읽어들일 때 어떻게 이들을 처리하며, 심지어 I/O 작업 중 전원이 나가는 등의 상황에서 어떻게 오류를 정정할 수 있을까? 또한 사용자는 다양한 비휘발성 저장장치에 대해, 이들의 세부사항을 모르더라도 open(), write()등 추상화된 syscall을 사용해 파일과 상호작용할 수 있다. 이를 OS는 어떻게 구현할까?
1. I/O Devices
I/O 장치들은 I/O를 다루기 위해 만들어진 I/O 칩을 통해 CPU와 상호작용한다. 이때 I/O 칩은 실제 장치와 연결되기 위한 다양한 인터페이스를 제공하는데,
- PCIe (Peripheral Component Interconnect Express),
- USB (Universal Serial Bus),
- SATA (Serial ATA(Advanced Technology Attachment)),
- IDE;PATA (Integrated Drive Electronics; Parallel ATA)
등이 있다.
1-1. Canonical Device / Protocol
대부분의 장치들은 표준적으로 다음과 같이 나타낼 수 있다.
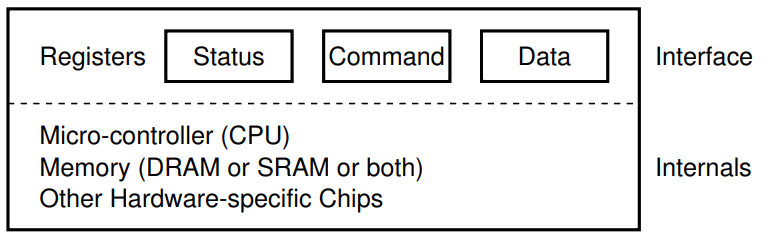
여기서 실제로 OS가 장치와 상호작용하기 위해 쓰이는 것은 register들이며, 각각에 대한 설명은 다음과 같다.
- Status register: 해당 장치의 현재 상태를 나타낸다.
예를 들어, 값이BUSY면 현재 장치가 작업중이고,WAITING이면 장치가 아무 작업도 하지 않고 대기중이라고 생각할 수 있다. - Command register: 해당 장치에 명령을 내릴 때 사용한다.
예를 들어, 값을 쓰고 싶을 때는WRITE를, 값을 읽고 싶을 때는READ를 쓸 수 있다. - Data register: OS에서 장치로, 장치에서 OS로 값을 보낼 때 사용한다.
예를 들어, 현재 쓰기 작업 중이라면 OS가 여기에 값을 쓰고 하드웨어가 값을 읽고 저장할 것이며, 현재 읽기 작업 중이라면 장치가 여기에 값을 쓰고 OS가 읽을 것이다.
이를 사용해서 기본적인 읽기와 쓰기 프로토콜을 대략적으로 C로 표현해보면 다음과 같을 것이다.
void io_write(uint64_t address, uint64_t data) {    // 한 번에 8바이트 쓸 수 있다 가정
  while (STATUS_REG == BUSY) {}   // spin-wait

  write(DATA_REG, address);
  write(COMMAND_REG, WRITE_CMD);  // 쓰기 작업 시작
  while (STATUS_REG != READY) {}  // 쓰기 작업이 준비될때까지 대기
  write(DATA_REG, data);          // 실제 데이터 전송

  while (STATUS_REG == BUSY) {}   // 쓰기가 끝날 때까지 대기
}

uint64_t io_read(uint64_t address) {  // 64-bit addressing을 쓴다 가정
  uint64_t data;

  while (STATUS_REG == BUSY) {}
  write(DATA_REG, address);
  write(COMMAND_REG, READ_CMD);   // 읽기 작업 시작
  while (STATUS_REG == BUSY) {}   // 작업이 끝날 때까지 대기

  read(DATA_REG, &data)           // 결과를 가져옴
  return data;
}
여기서 어떤 요청이 들어오면 해당 장치가 사용 가능할 때까지 계속해서 OS가 장치 상태를 확인하는 과정에 주목해볼 수 있다. 이렇게 OS가 장치의 상태를 계속해서 파악하며 사용 가능할 때까지 대기하는 것을
Polling
이라고 한다. 그러나 우리가 concurrency에서 계속 봐 왔듯 이런 방식은 CPU를 낭비하기 때문에 굉장히 비효율적이다.
1-2. Interrupt
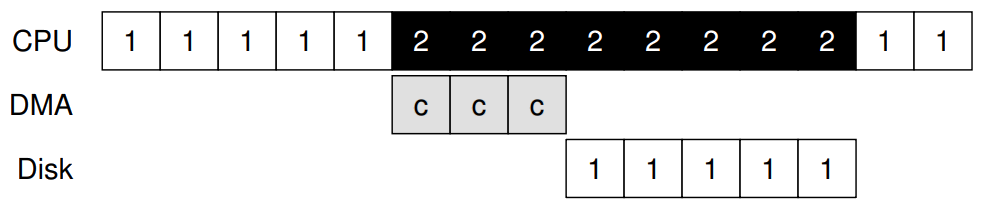
이렇게 장치가 사용 가능할 때까지 CPU를 낭비하면서 대기하는 것을 방지하기 위해 interrupt를 I/O 장치에도 도입하게 된다. 즉, 다음 그림과 같이 process 1이 I/O 장치에 작업을 하는 동안 polling 상태로 두는 것이 아니라, process 2가 CPU를 사용할 수 있도록 하는 것이다. 작업이 끝나고 나면 I/O 장치는 interrupt를 발생시키고, 이를 받은 OS는 process 1을 다시 실행시킨다. (물론 scheduling policy에 따라 process 1이 실행권을 다시 못 받게 될 수도 있다!)
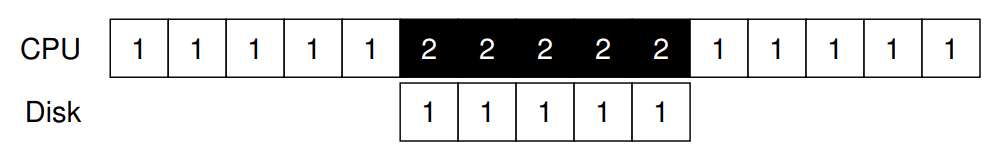
그러나 interrupt에도 단점이 있다. 굉장히 빠른 I/O 장치나 빠른 시간 안에 해결할 수 있는 가벼운 I/O 요청이 지속적으로 발생하는 상황을 생각해 보자. 두 가지 상황 모두에서, 어떤 프로세스가 I/O 작업을 시작하면 끝날 때까지 매우 짧은 시간이 걸릴 것이다. 이러한 경우에는 polling이 interrupt보다 효율적이다. Interrupt는 기본적으로 커널에서 처리되기 때문에, interrupt 발생 후 이를 처리하고 유저 영역으로 복귀하는 데에서 overhead가 발생하기 때문이다 (저번에 살펴본 KPTI때문에 kernel-user 전환이 굉장히 비싸다는 점을 고려하자).
따라서 polling의 장점과 interrupt의 장점을 한 번에 취하기 위해, polling과 interrupt를 섞는 방식을 고려해볼 수 있다. 예를 들어, I/O 요청을 날린 직후 짧은 시간 동안은 polling하다가 일정 시간을 넘어가면 interrupt를 쓰는 방식을 생각해볼 수 있다.
1-3. Direct Memory Access (DMA)
지금껏 우리는 소량의 데이터를 I/O 장치에 전달하는 것만 생각했지만, 실제로는 수GB, TB 단위의 데이터를 써야 하는 경우도 있다. 이러한 경우에는 메모리에 있는 데이터를 I/O 장치의 data register에 옮기는 데도 굉장히 많은 시간이 든다. 이렇게 데이터를 data register에 옮기는 동안은 CPU가 다음 그림처럼 아무 일도 하지 않게 된다 (c로 표현된 부분이 메모리에서 data register로 데이터를 복사하는 부분이다).
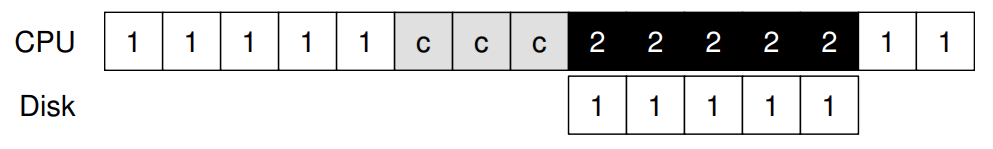
이를 해결하기 위해, 장치에 옮길 데이터의 메모리상 시작 주소와 크기를 주면 장치가 직접 메모리에 접근해 데이터를 읽어오는 것을 생각해볼 수 있다. 이를 direct memory access(DMA)라 하고, 이러한 방식을 사용하게 되면 다음 그림과 같이 데이터를 옮기는 시간에도 다른 프로세스가 실행될 수 있기 때문에 굉장히 효율적이다.
2. Device Drivers
그렇다면 실제로 장치의 data, command register에 값을 어떻게 읽고 쓸 수 있을까? 다시 말해, 위에서 봤던 대략적인 io_read()와 io_write()에서 write(DATA_REG, data)같은 부분이 어떻게 구현될 수 있을까?
2-1. I/O Instructions
첫 번째 방법은 I/O를 위한 instruction을 만드는 것이다. 실제로 x86에서는 이를 위해 in과 out을 제공한다.
이를 사용해 장치의 0xdead에서 값을 읽어오는 어셈블리는 대략적으로 다음과 같이 짤 수 있다.
mov al, 0xdead
out al, 0x10   ; 연결된 I/O 장치의 포트번호가 0x10이라 하자
in  al, 0x11   ; 0x11은 해당 장치의 data이다
; 이제 al은 해당 장치의 0xdead번지에 있는 값이 된다.
2-2. Memory-Mapped I/O (MMIO)
그러나 이는 굉장히 불편하다. 이를 해결하기 위해 일반적으로 메모리에 읽고 쓰는 것처럼 I/O 장치와 통신할 수 있도록 하는 방식이 등장했다. 이를 I/O 장치들이 메모리 위에 올라와있는 것 같다 하여 memory-mapped I/O (MMIO)라 한다.
이를 위해 I/O 장치는 해당 장치가 쓰는 주소 영역에 접근이 일어나면 반응하도록 설계된다. 예를 들어, 주소 0x1000부터 0x2010까지 쓰는 장치는 다음과 같이 제어할 수 있을 것이다.
volatile char *DATA_REG = 0x1000
volatile unsigned long *STATUS_REG 0x2000
volatile unsigned long *COMMAND_REG 0x2008

char buf[0x1000];

*(unsigned long *)DATA_REG = 0xdead;   // 읽을 주소
*COMMAND_REG               = READ;     // 읽기 시작
while (*STATUS_REG == BUSY) {}         // 끝날때까지 대기

memcpy(buf, DATA_REG, 0x1000);         // 결과를 가져옴
I/O 장치와 통신하는 과정이 메모리에 접근하는 것과 동일하게 일어나기 때문에 매우 편리하다.
2-3. Drivers
그러나 memory-mapped I/O에는 치명적인 단점이 있는데, 사용자가 장치를 사용하기 위해서는 해당 장치가 어느 주소를 사용하는지 전부 알아야 한다는 것이다. 즉 사용자는 장치를 바꿀 때마다 해당 장치의 설명서를 읽고, 코드를 전부 수정해야 한다. 이를 단일화된 open(), read()등의 syscall을 통해 사용자가 장치의 실제 구현을 모른 상태에서도 사용할 수 있도록 device driver가 등장했다.
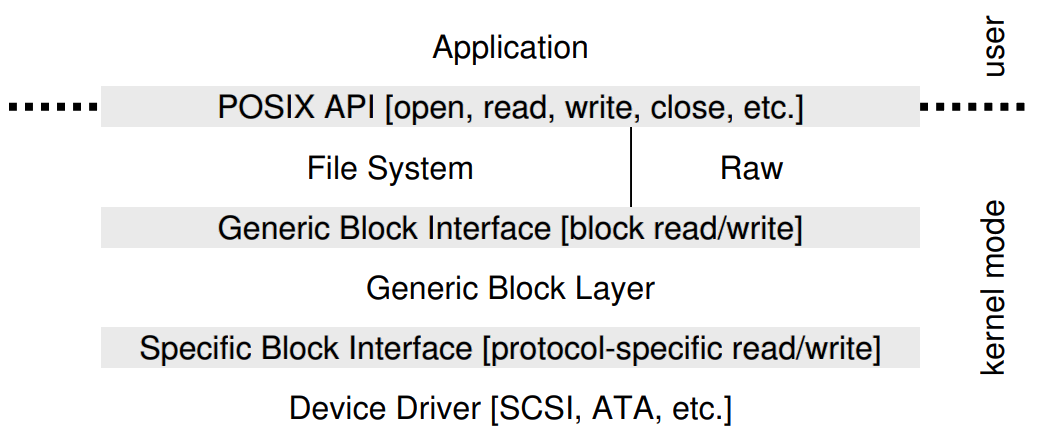
Device driver은 기본적으로 추상화된 요청을 받아, device-specific하게 요청을 변환하는 역할을 한다. 실제로 Linux는 위의 그림처럼, 사용자가 API를 통해(syscall을 통한 것이나 마찬가지다) I/O 요청을 발생시키면 이는 generic block layer에 전달되고, generic block layer는 해당 요청에 맞는 device driver에 전달해 요청을 처리하게 된다.
그러나 여기에도 문제점이 있다. 장치가 아무리 많은 기능을 제공하더라도, OS가 이를 위한 API를 만들어주지 않으면 사용할 수 없다는 것이다. 예를 들어, I/O 장치의 오류를 하나의 오류 코드로만 처리하는 OS가 있다고 하자. 그렇다면 장치가 아무리 많은 오류를 제공하더라도(예를 들어, 시간이 초과했다거나 전력이 부족하다거나 데이터가 모종의 이유로 손상됐다거나 하는 등) 유저가 볼 수 있는 오류는 하나뿐이라는 것이다.
참고 - Hardware Abstraction Layer (HAL)
운영체제를 공부하다 보면 HAL이라는 용어를 들을 때가 있다. HAL도 디바이스에 대한 추상화를 구현한다는 점에서는 device driver와 비슷하나, 하는 역할이 좀 다르다.
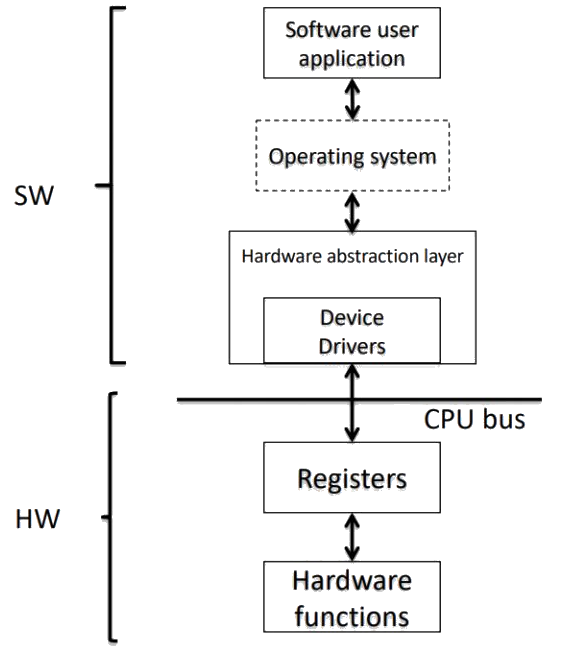
일반적으로 HAL은 추상화된 요청을 받아 디바이스 드라이버로 요청을 넘긴다. 그림으로 표현하면 아래와 같다.
HAL의 뼈대는 OS가 정해준다. 예를 들어, 카메라 장치에 대한 HAL은
cameraON(),cameraOFF(),takePicture()이 있어야 한다는 식이다. 제조사는 해당 함수의 내부 구현을 맡는다. 예를 들어,cameraON()을 실행했을 때, 디바이스 드라이버로 어떤ioctl()요청을 보낼지를 결정한다는 것이다. (OOP 관점에서, HAL은 interface class와 비슷한 느낌이라고 생각하면 된다.)예를 들어, 디바이스 A의 드라이버는
ioctl 1이 카메라를 켜는 역할,ioctl 2가 카메라를 끄는 역할을 한다고 가정하자. 그렇다면 디바이스 A의 HAL은cameraON()을 실행했을 때 해당 디바이스 드라이버로ioctl 1요청을 날리고,cameraOFF()를 실행했을 때ioctl 2를 날릴 것이다. 반대로 디바이스 B의 드라이버는ioctl 1이 카메라를 끄는 역할,ioctl 2가 카메라를 켜는 역할이라고 하면 해당 디바이스의 HAL도 이에 맞게 구현될 것이다.디바이스 드라이버는
ioctl()요청을 받아, 실제 하드웨어에 명령을 내리는 역할을 한다. 예를 들어, 장치가 MMIO를 따른다면 해당 주소에 값을 실제로 쓰는 역할을 하는 것이 드라이버이다.
3. Hard Disk Drive (HDD)
3-1. Components
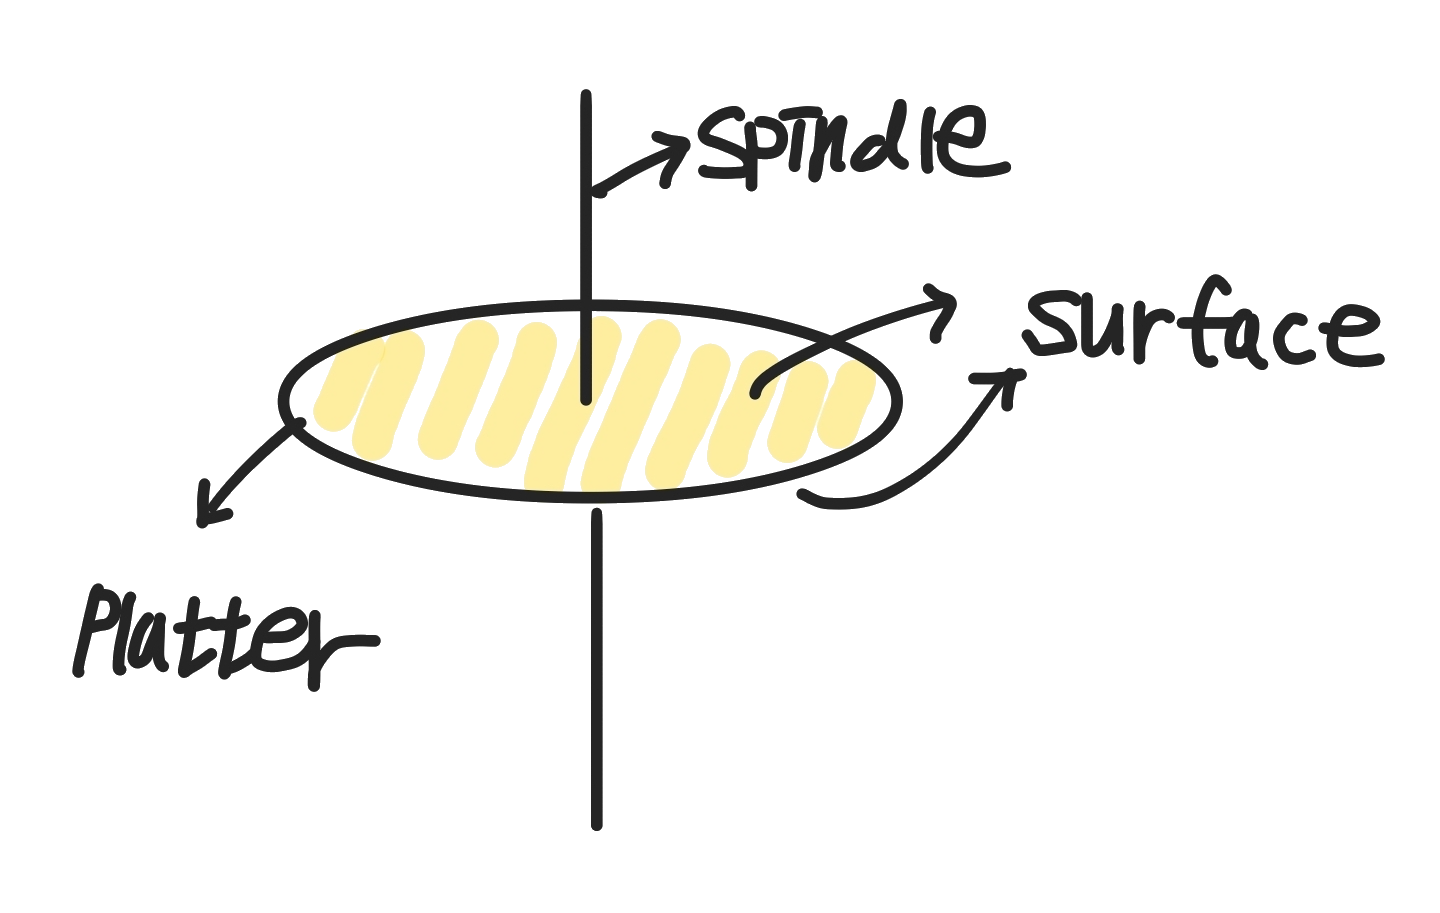
이제 대표적인 비휘발성 메모리인 HDD의 구성을 알아보자. 우선 HDD는 spindle을 중심으로 하는 platter가 여러 개 있는 구조이다. 각 platter의 양쪽 면을 surface라고 한다. 그림으로 표현하면 다음과 같다.
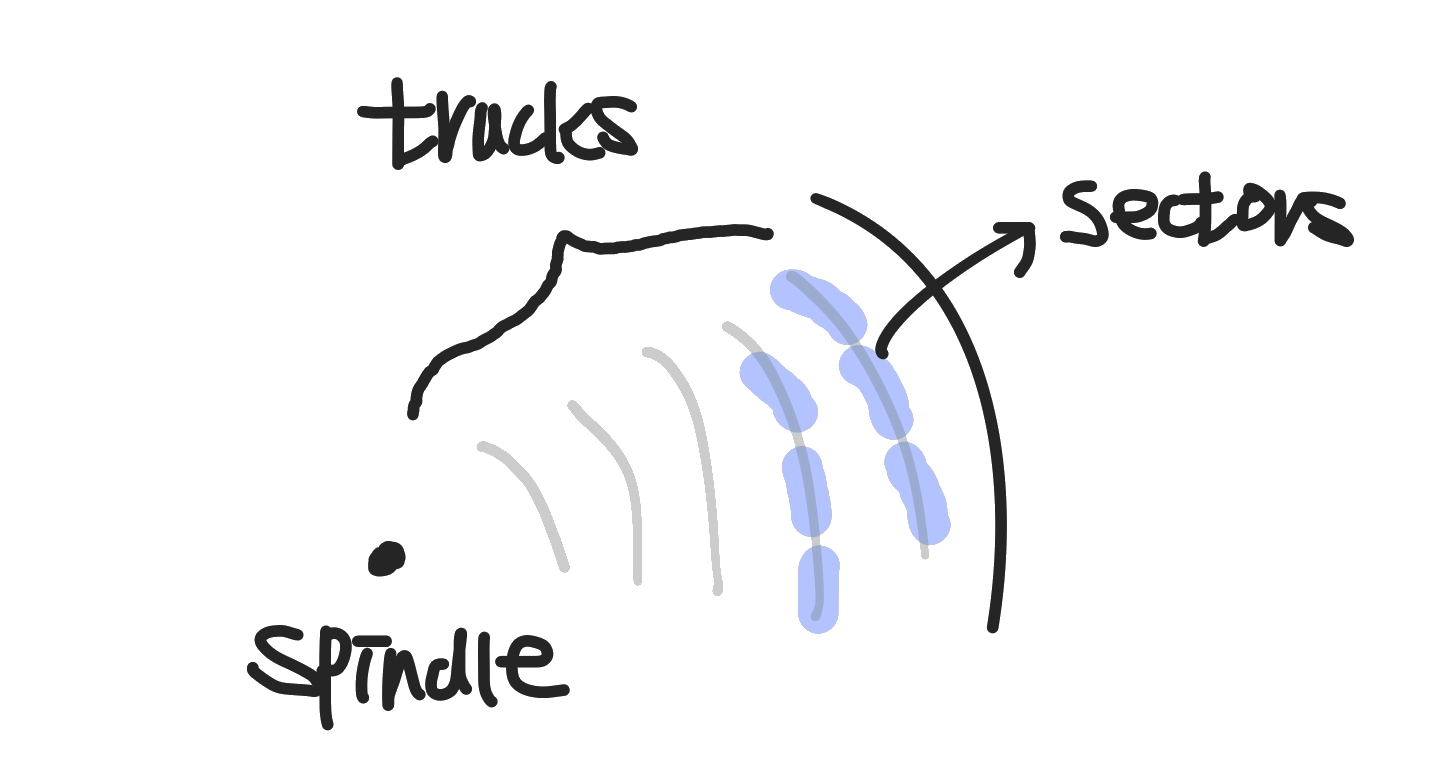
데이터는 surface 위에 기록된다. 데이터는 연속적으로 spindle을 중심으로 하는 동심원 위에 기록되며, 이때 한 동심원을 track이라 부른다. 또한 track을 일정한 용량으로 나눠놓은 단위를 sector라고 한다. 그림으로 표현하면 다음과 같다.
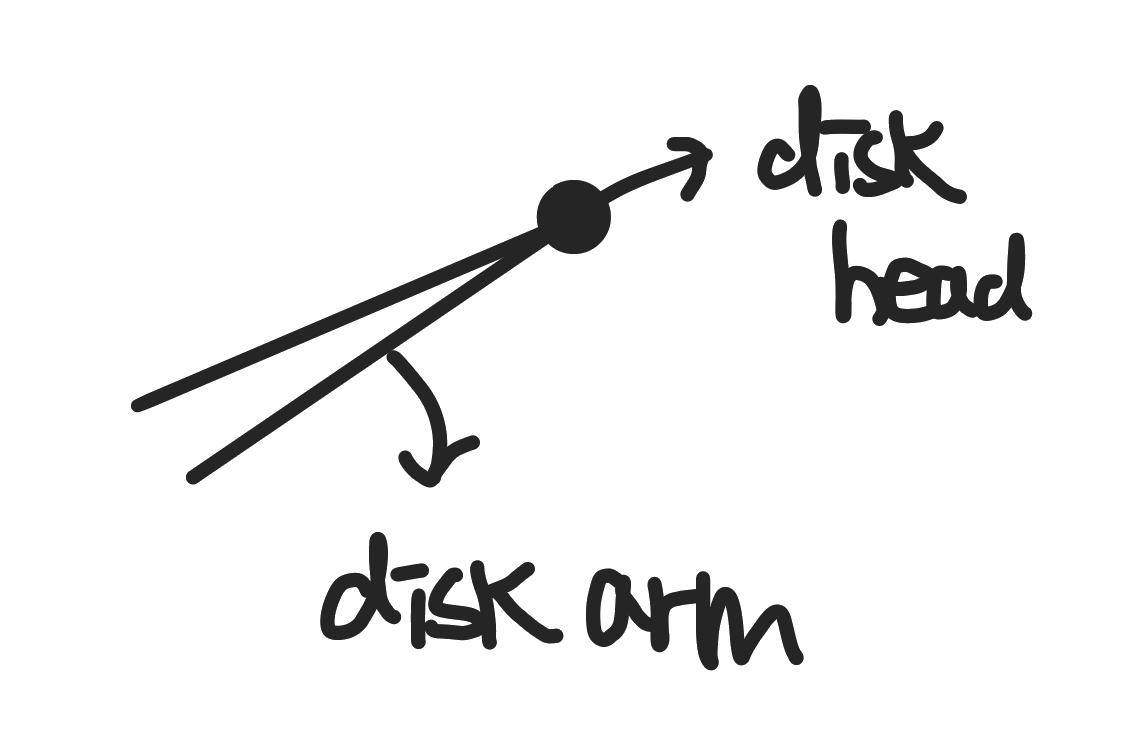
surface 위의 데이터들은 disk head라 불리는 부분에 의해서 기록되고 쓰여진다. Disk head는 disk arm에 부착되어 있으며, 해당 부분은 surface 위에서 움직이며 목표한 track에 disk head를 위치시킨다.
3-2. Delays
이제 디스크를 읽을 때 생기는 지연 시간에 대해 알아보자.
3-2-1. Rotational Delay
Rotational delay는, disk arm이 목표 track에 위치하고 있을 때, 목표 sector까지 이동하는 데 걸리는 시간을 나타낸다. Platter들은 spindle을 중심으로 회전하고 있기 때문에, platter가 회전해 disk head가 원하는 sector에 오기까지 기다려야 한다. 이를 rotational delay라고 한다.
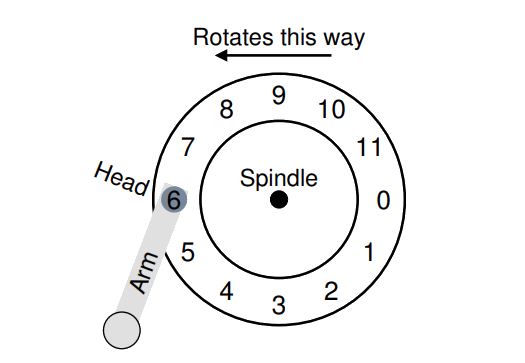
예를 들어, 위의 상황에서 disk head는 6번 sector위에 있다. 만약 0번 sector를 읽으려고 한다면, 해당 platter가 회전해 0번 sector가 disk head 아래 올 때까지 기다려야 한다.
Platter가 한 번 회전할 때 걸리는 시간을 $R$이라고 한다면, rotational delay의 최솟값은 $0$(원하는 sector가 disk head 아래 위치한 경우)이고 최댓값은 $R$(원하는 sector를 막 지나친 경우)이기 때문에, 평균적으로 rotational delay는 $\frac{R}{2}$이다.
3-2-1. Seek Time
Seek time은 disk arm이 목표 track까지 가는 데 걸리는 시간을 의미한다.
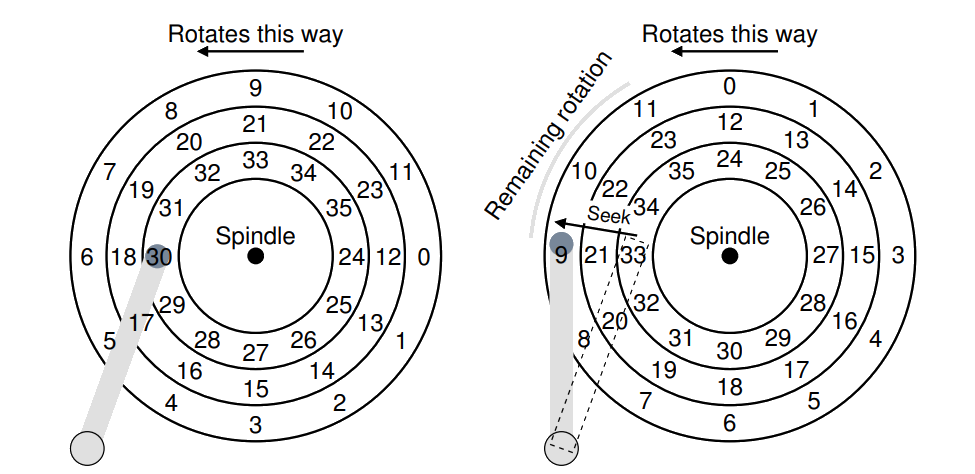
예를 들어, 위 그림에서 disk head는 가장 안쪽 track에 위치하고 있지만, 11번 sector를 읽고 싶다고 하자. 그렇다면 disk arm은 disk head를 가장 바깥쪽 track에 위치시켜야 하고, 이를 하는 데 걸리는 시간을 seek time이라 한다. 그림에서는 seek이 일어난 이후에도 disk head가 원하는 sector에 오기까지 rotation이 일어나야 한다.
3-3. I/O Time / I/O Rate
이제 위에서 살펴본 지표들을 통해 디스크의 성능을 측정하는 방법을 알아본다. 우선 I/O Time은 OS가 처음 데이터를 요청한 시점부터 데이터 전송이 끝난 시점까지의 시간을 의미한다. 즉,
\[T_{I/O} = T_{seek} + T_{rotation} + T_{transfer}\]여기서 $T_{transfer}$는 데이터를 전송하는 데 걸린 시간을 의미한다. 즉, 최대 전송 속도를 $M$, 전송할 데이터 크기를 $S$라고 하면
\[T_{transfer} = \frac{S}{M}\]이다. 예를 들어, 10MB/S 속도로 데이터를 전송할 수 있는 디스크가 100MB의 데이터를 전송하는 데 걸리는 시간 $T_{transfer}$은
\[T_{transfer} = \frac{100\text{MB}}{10\text{MB/s}} = 10\text{s}\]이다.
그러나 $T_{I/O}$는 전송할 데이터의 크기에 따라 그 값이 달라지기 때문에, 일반적으로 디스크의 성능을 평가할 때는 전체 $T_{I/O}$에 대한 데이터 크기의 비율인 I/O rate
\[R_{I/O} = \frac{\text{Size}_{transfer}}{T_{I/O}}\]를 사용한다.
참고
여기서 rotation과 seek은 동시에 일어나는데, 왜 $\max${$T_{seek}, T_{rotation}$}으로 계산하지 않는지 의문이 들 수 있다.그러나 여기서 중요한 사실은 rotation은 디스크의 상태와 관계없이 항상 일정한 속도로 일어나고 있다는 것이다. 만약 디스크가 평상시 돌고 있지 않다면 seek이 되는 속도에 맞춰 platter를 돌려서 두 동작이 병렬적으로 일어날 수 있게 할 수 있지만, 그렇지 않기 때문에 여기서 rotational delay의 의미는 seek이 “일어난 후”에도 평균적으로 얼마를 더 기다려야 목표 section에 도달할 수 있냐로 봐야 한다.
3-4. Example
예를 들어, 다음과 같은 HDD를 가정하자.
| RPM | 15,000 |
| Average Seek | 4ms |
| Max Transfer | 125MB/s |
이 HDD에 대한 rotational delay는 다음과 같이 계산될 수 있다.
\[\begin{aligned} T_{rotation} &= \frac{1}{2} \cdot \frac{1 \text{ rotation}}{15\,000 \text{ rotation/min}} \\ &= \frac{1}{2} \cdot 0.00006666666 \text{ min} \\ &= 0.00003333333 \text{ min} \approx 2 \text{ ms} \end{aligned}\]3-4-1. Random Read
이제 비교적 작은 데이터를 읽는 경우(이러한 경우는 디스크에서 random access가 일어나는 경우이다)를 살펴보자. 예를 들어, 일반적인 sector 크게인 4KB를 읽는 상황이라 하자. 이러한 경우에서 $T_{transfer}$은
이다. 따라서
\[\begin{aligned} T_{I/O} &= T_{seek} + T_{rotation} + T_{transfer} \\ &=4\text{ ms} + 2 \text{ ms} + 30\text{ }\mu\text{s} \\ &\approx 6 \text{ ms} \end{aligned}\]이고,
\[\begin{aligned} R_{I/O} &= \frac{\text{Size}_{transfer}}{T_{I/O}} \\ &= \frac{4\text{ KB}}{6 \text{ms}} = \frac{4\text{ MB}}{6 \text{s}} \\ &\approx 0.66 \text{ MB/s} \end{aligned}\]3-4-1. Sequential Read
이제 데이터를 순차적으로 읽는 상황을 가정해 보자. 이러한 상황에서는 보통 데이터를 한 번에 많이 읽기 때문에, 대략 100MB를 읽는 상황을 가정하자. 아까와 마찬가지로 계산하면,
따라서 sequential read 상황에서는 거의 max transfer 속도에 가깝게 나오는 것을 알 수 있다.
4. Disk Scheduling
위에서 봤듯, disk I/O 작업은 메모리에 읽고 쓰는 것보다 훨씬 시간이 많이 든다. 따라서 OS는 읽기와 쓰기 작업을 최적화하기 위해 어느 정도의 scheduling이 필요한데, 대표적인 방법은 다음과 같다.
4-1. Shortest Seek Time First (SSTF)
해당 방법은 현재 disk head가 위치해있는 track에서 가장 가까운 sector를 최우선으로 처리하는 방법으로, seek time을 최소화하기 위한 전략이다.
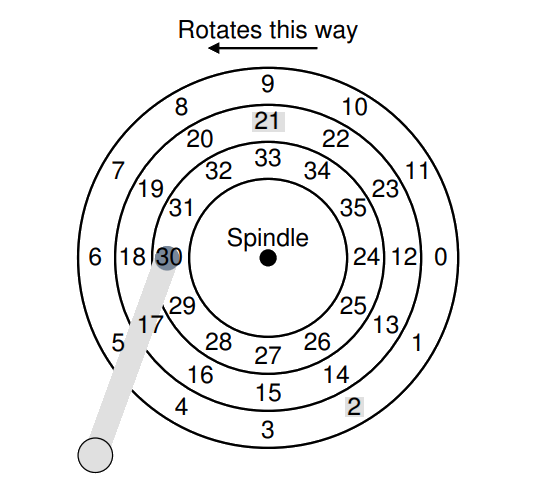
위의 예시에서, 현재 disk head는 가장 안쪽 track에 위치해 있다. 따라서 21번 sector, 2번 sector에 대한 요청이 들어온다면 SSTF는 21번 sector의 요청을 먼저 처리하고, 다음으로 2번 sector의 요청을 처리할 것이다.
그러나 이 방법은 disk head와 가까운 track에 대한 요청이 많이 들어올 때, disk head에서 먼 곳에 있는 track에 대한 요청에 대해 starvation 문제가 발생할 수 있다는 단점이 있다.
4-2. SCAN
이 방법은 SSTF의 starvation 문제를 해결하기 위해 고안된 방법이다. 이 방법은 disk head를 순차적으로 가장 안쪽 track부터 가장 바깥족 track까지 이동시키며 해당 track에 대한 요청을 처리하는 방식이다. 이때 가장 안쪽부터 가장 바깥쪽 track까지 disk head가 한 번 움직이는 과정을 sweep이라고 한다.
예를 들어, 가장 안쪽 track인 1번 track부터 10번 track까지 있는 HDD를 가정하자. 현재 disk head 위치가 4번 track이고 다음과 같은 track 순서대로 요청이 발생했다.
1, 6, 7, 5, 2
SCAN은 첫 번째 sweep(가장 안쪽에서 바깥쪽으로 나가는 sweep이라 하자)에서 순서대로 6, 7에 대한 요청을 처리할 것이다. 이후 10번 track에 도달하면, 두 번쨰 sweep(10번 track부터 1번 track까지 가는 sweep)을 시작할 것이고, 이 과정에서 5, 2, 1에 대한 요청이 처리될 것이다.
4-3. Shortest Positioning Time First (SPTF)
해당 방법은 scheduling policy의 SJF와 비슷한 방식으로, 현재 disk head로부터 가장 가까운 sector에 대한 요청부터 순차적으로 처리하는 것이다. 예를 들어, 다음과 같은 상황을 가정하자.
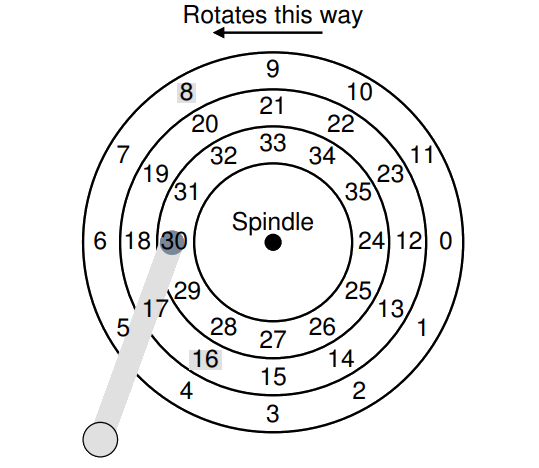
이 상황에서 8번 sector와 16번 sector에 대한 요청이 들어왔다면, 어느 것부터 처리해야 할까? 8번 sector는 $T_{rotation}$은 짧지만 $T_{seek}$은 길다. 이와 반대로 16번 sector은 $T_{seek}$은 짧지만 $T_{rotation}$은 길다. 이와 같은 상황에서, OS는 HDD에 대한 자세한 정보는 잘 모르기 때문에 어느 sector가 가장 짧은 시간 안에 도달할 수 있는지 모른다. 따라서, SPTF는 보통 OS가 아니라 HDD 안에서 일어나게 된다.
이를 위해, OS는 이전처럼 한 번에 한 개의 요청만을 보내는 것이 아니라, 현재 대기 중인 I/O 작업 중 일부를 선별해 HDD로 보내게 된다. 이후 HDD는 OS로부터 받은 몇 개의 요청을 SPTF로 scheduling한 후 순차적으로 처리하게 된다. 이렇게 되면 유저가 I/O 작업을 요청했을 때 OS는 바로 HDD에 요청을 보내는 것이 아니라 일정 시간 동안 해당 작업을 큐에 보관해 두고 (즉, 일정 시간 동안 I/O 작업을 미루게 된다), 한꺼번에 보내게 되는데 이러한 방식을
non-work-conserving
하다고 한다. 반대로, OS가 요청을 받자마자 HDD에 요청을 보내는 것을
work-conserving
하다고 한다.
보통 OS는 non-work-conserving 방식을 사용한다. 이러한 방식을 사용하면 SPTF뿐만 아니라 요청을 합치는 (예를 들어, 34번 sector에 대한 요청이 들어온 후 33번 sector에 대한 요청이 들어오면 이 둘을 합쳐 sequential read로 바꿀 수 있다) 것도 가능해지기 때문이다.
Leave a comment