[CS][OS] Virtualization - Swapping
이 글은 Andrea Arpaci-Dusseau and Remzi Arpaci-Dusseau의 Operating Systems: Three Easy Pieces를 참고한 글입니다.
여기에서 무료로 볼 수 있습니다.
0. Introduction
지금까지 우리는 segmentation과 paging을 다루며 물리 메모리가 무한하다고 생각해 왔다. 다시 말해, 어떤 process가 특정 page에 대한 접근을 요청했을 때 해당 page가 항상 메모리에 존재한다고 가정한 것이다. 그러나 현실적으로 이것은 불가능하다. 물리 메모리가 무한하지 않기 때문이다. 그러나 OS는 물리 메모리의 용량 자체가 적거나 메모리를 많이 요구하는 process가 실행 중일 때에도 모든 process가 무한한 메모리를 사용 중이며 자신이 요청한 page가 항상 메모리 위에 올라와 있다고 생각하게 만들어야 한다. 이렇게 메모리가 부족한 상황에서도 메모리에 대한 virtualization을 유지하기 위해 등장한 것이 swapping이다.
1. Swap
1-1. Swap Space
기본적으로 컴퓨터에는 RAM보다 보조기억장치인 HDD, SSD등의 용량이 더 많을 수밖에 없다. 따라서 OS는 이러한 보조기억장치에 swap partition을 만들어 둔다. 이렇게 만들어진 공간을 swap space라고 한다.
이후 OS는 물리 메모리가 부족할 때 저장된 page의 일부를 보조기억장치에 저장하고, 다시 해당 page가 필요해지면 보조기억장치에 저장된 page를 읽어 메모리에 로드한다. 이때,
- 메모리에서 저장 장치로 page가 이동할 때, 즉 page가 swap space로 진입하는 것을 page out이라 한다.
- 저장 장치에서 메모리로 page가 이동할 때, 즉 page가 swap space에서 나오는 것을 page in이라 한다.
1-2. Present Bit
앞선 글에서, PTE의 구조를 이야기하며 위 그림처럼 present bit이 있다는 것을 언급했었다. Present bit이
1이면, 해당 page가 물리 메모리에 있다는 것을 나타낸다.0이면, 해당 page가 물리 메모리에 없고 swap space 안에 있다는 것을 나타낸다.
이때, P=0인 경우를 page fault라고 하며, page fault가 발생했을 때, 해당 page를 물리 메모리에 로드하는 과정, 즉 page in이 필요하다. 이 과정은 보통 OS의 page fault handler가 담당한다.
참고
TLB에도 PTE의 정보가 저장된다는 점을 기억하자. 다시 말해, TLB hit 상황에서도 present bit을 보고 해당 page가 물리 메모리 안에 존재하는지 존재하지 않는지를 판단할 수 있다.
1-3. Dirty Bit
Dirty bit은 다음과 같이 해당 page가 page in 된 이후 내용이 업데이트되었는지 여부를 나타낸다.
D=0이면, 해당 page는 page in 된 이후 값이 변경되지 않았다.D=1이면, 해당 page는 page in 된 이후 값이 변경되었다.
만약 page out 대상인 page의 dirty bit이 1이라면, 이 page는 디스크에 저장된 페이지와 내용이 다르기 때문에 디스크에 다시 내용을 옮겨줘야 한다. 그러나 dirty bit이 0이라면, 해당 page는 디스크에 저장된 것과 내용이 같기 때문에 굳이 디스크에 다시 쓸 필요 없이 메모리에서 제거해주기만 하면 된다. 일반적으로 disk I/O는 굉장히 시간이 오래 걸리는 작업이기 때문에, dirty bit을 통해 불필요한 disk I/O를 줄임으로써 swapping의 성능을 향상할 수 있다.
1-4. 문제점
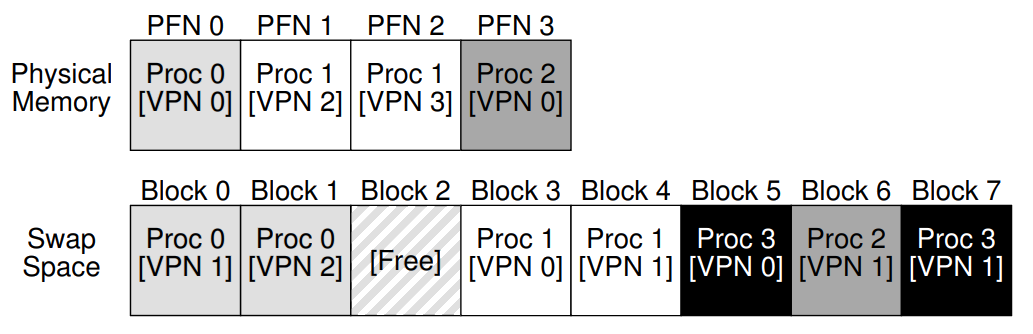
그러나 swapping에는 중요한 문제가 하나 있다. 예를 들어, 위의 그림과 같은 상황을 가정하자. 현재 Process 3의 page는 전부 page out되어 swap space에 저장되어 있는 상황이다. Process 3의 code 영역은 VPN=0에 저장되어 있다고 하자. 이제 OS가 process 3을 schedule해 process 3에서 instruction fetch가 일어난다 생각하자. 이 경우, 무조건 page fault가 발생하게 되고, OS는 process 3의 VPN=0이 가리키는 page, 즉 swap space의 block 5를 물리 메모리에 옮기는 과정이 필요하다.
그러나 현재 상태에서는 물리 메모리도 가득 차 있기 때문에, 물리 메모리에서 최소한 1개의 page가 page out되어야 한다. 이때 어떤 page를 page out할지 결정하는 알고리즘이 필요하다.
지금까지의 정보를 바탕으로 swap이 동작하는 방식을 슈도코드로 나타내면 다음과 같다. (swap에만 집중하고, 그 외의 부가적인 것들은 뺐다)
// Address translation
TLB_entry = TLB_lookup(VPN)
// TLB hit 상황만을 가정
if (!TLB_entry.present) {
  raise(PageFault)
}

// Page fault handler
free_PFN = find_free_physical_page()
if (free_PFN == -1) {
    // 물리 메모리가 가득 찬 경우
    // 정해진 알고리즘에 따라 page를 page out한 후
    // 해당 page에 디스크에 있는 page를 덮어쓴다.
    free_PFN = page_out()
}
// page out될 때 PTE에 디스크에 저장된 위치가 저장된다 가정
disk_read(PTE.disk_address, PFN)
PTE.present = 1
PTE.PFN = PFN
2. Policy
앞서, page in이 필요한 상황에서 물리 메모리가 가득 차서 물리 메모리의 page를 page out해야 하는 경우 page out의 대상을 결정하는 알고리즘이 필요하다. 여기서는 3개의 알고리즘을 살펴보고, 이를 종합해 리눅스 커널이 동작하는 방식을 알아본다.
2-1. FIFO
Scheduling policy에서 살펴봤듯, FIFO는 단순히 물리 메모리에 가장 먼저 들어온 page를 page out 시키는 방법이다. 예를 들어, 어떤 프로세스가 다음과 같은 순서로 page에 접근한다 치자. 물리 메모리는 3개의 page를 담을 수 있는 크기가 있다고 가정한다.
| Time | T1 | T2 | T3 | T4 | T5 | T6 | T7 | T8 |
| Page | 0 | 1 | 2 | 3 | 0 | 1 | 2 | 3 |
이러한 경우에서, 물리 메모리에 들어있는 page는 다음과 같이 바뀔 것이다.
| Time | 물리 메모리 | 디스크 | |
|---|---|---|---|
| T1 | 0 | ||
| T2 | 0 1 | ||
| T3 | 0 1 2 | ||
| T4 | 1 2 3 | 0 | 0이 swap out, 1이 swap in |
| T5 | 2 3 0 | 1 | 1이 swap out, 2이 swap in |
| T6 | 3 0 1 | 2 | 2이 swap out, 3이 swap in |
| T7 | 0 1 2 | 3 | 3이 swap out, 0이 swap in |
| T8 | 1 2 3 | 0 | 0이 swap out, 1이 swap in |
이 방식은 간단하지만, 효율적이지 않다는 단점이 있다. 위의 예시에서는 모든 page가 동일한 횟수만큼 사용됐지만 실제 프로그램은 많이 사용하는 특정 page가 존재할 수밖에 없다. 그러나 FIFO는 사용량을 고려하지 않고 오로지 들어온 순서에 의해서만 page out을 결정하기 때문에, page fault가 많이 일어나고 따라서 오버헤드가 많이 발생하게 된다.
2-2. Random
또 다른 간단한 방법은 page out 대상을 랜덤으로 고르는 것이다. 이는 운에 따라 FIFO보다 좋은 성능을 낼 수 있지만 (우연히 많이 사용되는 page가 걸리지 않는 경우) 성능을 완전히 운에 맡기는 것이기 때문에 실제로 쓰이기에 적합한 방식은 아니다.
2-3. LRU/LFU
FIFO와 random의 가장 큰 문제점은 중요한 page(즉, 많이 사용되는 page)를 page out 대상으로 선정할 수 있다는 것이었다. 이름에서 알 수 있듯, LRU(Least-Recently-Used)는 가장 오래 전 사용된 page를 page out 대상으로 선정한다. 이는 temporal locality에 기반한 것으로, 가장 최근에 쓰인 page는 짧은 기간 내 다시 사용될 확률이 높고, 가장 오래 전 사용된 page는 다시 사용될 확률이 낫다는 아이디어에 기반한다. 다만 LRU는 page를 사용된 시간순으로 계속해서 정렬해야 한다는 부담이 존재한다.
비슷하게, LFU(Least-Frequently-Used)는 가장 적게 사용된 page를 page out 대상으로 선정한다. 마찬가지로 LFU는 page들을 사용량 순서대로 정렬해놔야 한다는 부담이 존재하며, 대부분의 경우에서 LRU와 비슷한 성능을 낸다.
참고
LRU/LFU와 완벽히 반대되는 개념으로, MRU(Most-Recently-Used)와 MFU(Most-Frequently-Used)가 있다.
당연하게도, 이 방식을 적용시키면 대부분의 경우에서 최악의 성능을 낼 수 있을 것이다.
예를 들어, 어떤 프로세스가 다음과 같은 순서로 page에 접근한다 치자. FIFO의 예시 상황과 같이 물리 메모리는 3개의 page를 담을 수 있는 크기가 있다고 가정한다.
| Time | T1 | T2 | T3 | T4 | T5 | T6 | T7 | T8 |
| Page | 0 | 0 | 1 | 0 | 2 | 3 | 0 | 0 |
이러한 경우에서, 물리 메모리에 들어있는 page는 다음과 같이 바뀔 것이다.
| Time | 물리 메모리 | 디스크 | |
|---|---|---|---|
| T1 | 0 | ||
| T2 | 0 | ||
| T3 | 1 0 | ||
| T4 | 0 1 | 0이 다시 쓰였기 때문에 재정렬 | |
| T5 | 2 0 1 | ||
| T6 | 3 2 0 | 1 | 가장 오래전에 쓰인 1이 swap out |
| T7 | 0 3 2 | 1 | 0이 다시 쓰였기 때문에 재정렬 |
| T8 | 0 3 2 | 1 |
여기서 중요한 것은 T6와 T7이다. 만약 FIFO였다면 T6에서 0이 page out되고, T7에서 다시 page in 되었을 것이다. 그러나 LRU를 적용하면 0대신 1이 swap out되기 때문에, swap in/out에 대한 오버헤드가 그만큼 감소하게 된다.
2-4. Linux
리눅스는 기본적으로 4KB page를 사용하지만 가변 page 크기를 지원한다. 따라서 LRU를 그대로 사용하면 문제점이 발생하기 때문에 2Q Replacement라는 방법을 변형한 방식을 사용한다. 이는 inactive list와 active list라는 2개의 queue를 통해 다음과 같이 page를 관리한다.
- 처음 page가 쓰이면, 이 page는
inactive list에 저장된다. inactive list에 저장된 page가 다시 쓰이면,active list에 저장된다.- 주기적으로
active list의 바닥에 있는 page들을inactive list로 옮긴다. - Page out이 필요한 경우,
inactive list에서 고른다.
이 방식은 평상시에는 LRU와 비슷하게 동작하지만, 다음과 같은 상황에서 LRU보다 효율적으로 동작한다.
예를 들어, process가 큰 page(거의 물리 메모리 크기에 근접한다 가정하자) A에 한 번만 접근한다 생각하자. 이 경우, LRU는 다음과 같이 동작한다.
- 처음
A에 접근하면, 물리 메모리에 있던 대부분의 page가 page out되고A가 메모리에 올라올 것이다. - 다음으로 작은 크기의 page에 접근하더라도,
A는 최근에 들어온 page이기 때문에 다른 page들이 page out되고 page in되는 상황이 반복적으로 발생할 것이다. A가 least-recently-used page가 되기 전까지 이 과정은 계속 반복될 것이다.
그러나 리눅스는 A를 inactive list에 저장하기 때문에, LRU보다는 빨리 A를 page out 대상으로 선정할 것이다.
3. 참고 - KPTI
이 부분의 내용은 CVE-2017-5754(Meltdown)과 CVE-2017-5753, CVE-2017-5715(Spectre)에 대한 내용입니다.
자세한 내용은 여기(Meltdown)과 여기(Spectre)를 참고하시길 바랍니다.
[Kernel Exploit Tech][Pawnyable] LK01 - Stack Overflow글에서, KPTI(Kernel Page Table Isolation)이 적용되면 커널에서 iretq를 통해 유저 영역으로 실행 흐름을 옮겨도 유저 영역의 코드 실행이 불가능해진다고 언급했다. 이는 커널과 유저 영역의 page table 자체가 분리되어 있기 때문이고, KPTI trampoline를 사용해 OR cr3, 0x1000 연산을 실행시켜줘야 정상적으로 동작했다.
그러나 지금까지 우리가 살펴본 방법은 딱히 유저의 page table과 커널의 page table을 분리시키지 않았다. 오히려 이 둘이 같이 존재하기 때문에, 편리한 점들이 많았다. 예를 들어, user process가 syscall을 발생시키면 실행 흐름이 바로 kernel의 syscall handler로 전환될 수 있었다. 그러나 KPTI가 도입되고 kernel/user 전환이 일어날 때마다 page table을 바꿔주는 것이 필요해졌고, 이로 인해 성능 저하가 발생했다.
Leave a comment