[CS][OS] Persistence - Log-structured File System (LFS)
이 글은 Andrea Arpaci-Dusseau and Remzi Arpaci-Dusseau의 Operating Systems: Three Easy Pieces를 참고한 글입니다.
여기에서 무료로 볼 수 있습니다.
0. Introduction
지금까지 살펴본 VSFS와 FFS 모두 파일을 만들거나 수정할 때 어쩔 수 없이 seek과 rotation이 일어나야 했다. 따라서 이들은 디스크의 sequential access 상황에서의 속도를 최대한 활용할 수 없었고, 따라서 어느 정도는 성능 저하를 감수해야 했다. 그러나 컴퓨터의 메모리 크기가 점점 커지며 disk I/O가 일어나기 전 cache되는 양이 점점 많아질 수 있었고, 따라서 sequential write가 더 쉬워졌다 (이전 글의 amortization을 생각해보자. Block size가 커지면 커질수록 sequential write 상황에서의 성능에 가깝게 write를 할 수 있었고, disk write가 일어나기 전 cache될 수 있는 양이 많아진다는 건 그만큼 block size가 커질 수 있다는 걸 뜻하는거나 마찬가지라고 이해하자). 이로부터 모든 disk write를 sequential write로 만들려는 시도가 생겨났고, 이로 인해 생긴 파일 시스템이
Log-structured File System (LFS)
이다.
1. Basic Concept
1-1. Storing
앞서 말했듯 기본적으로 LFS는 모든 disk write를 sequential write로 만드는 방식을 사용한다. 예를 들어, 파일 A를 만드는 상황을 가정하자. 해당 파일의 inode는 I[A]라고 표시하고, data block은 D[A]라고 표현하자. LFS는 다음과 같이 파일 A를 디스크에 저장한다.
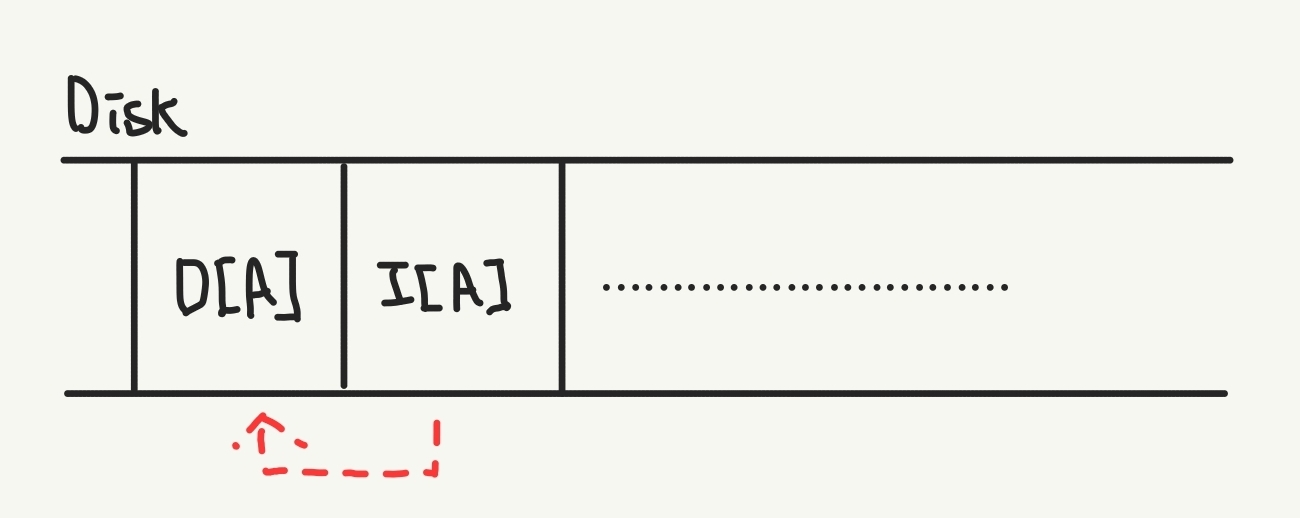
즉, 앞서 우리가 살펴봤던 파일 시스템들처럼 따로 inode section, data block section을 나누지 않고 순차적으로 저장하는 것이다.
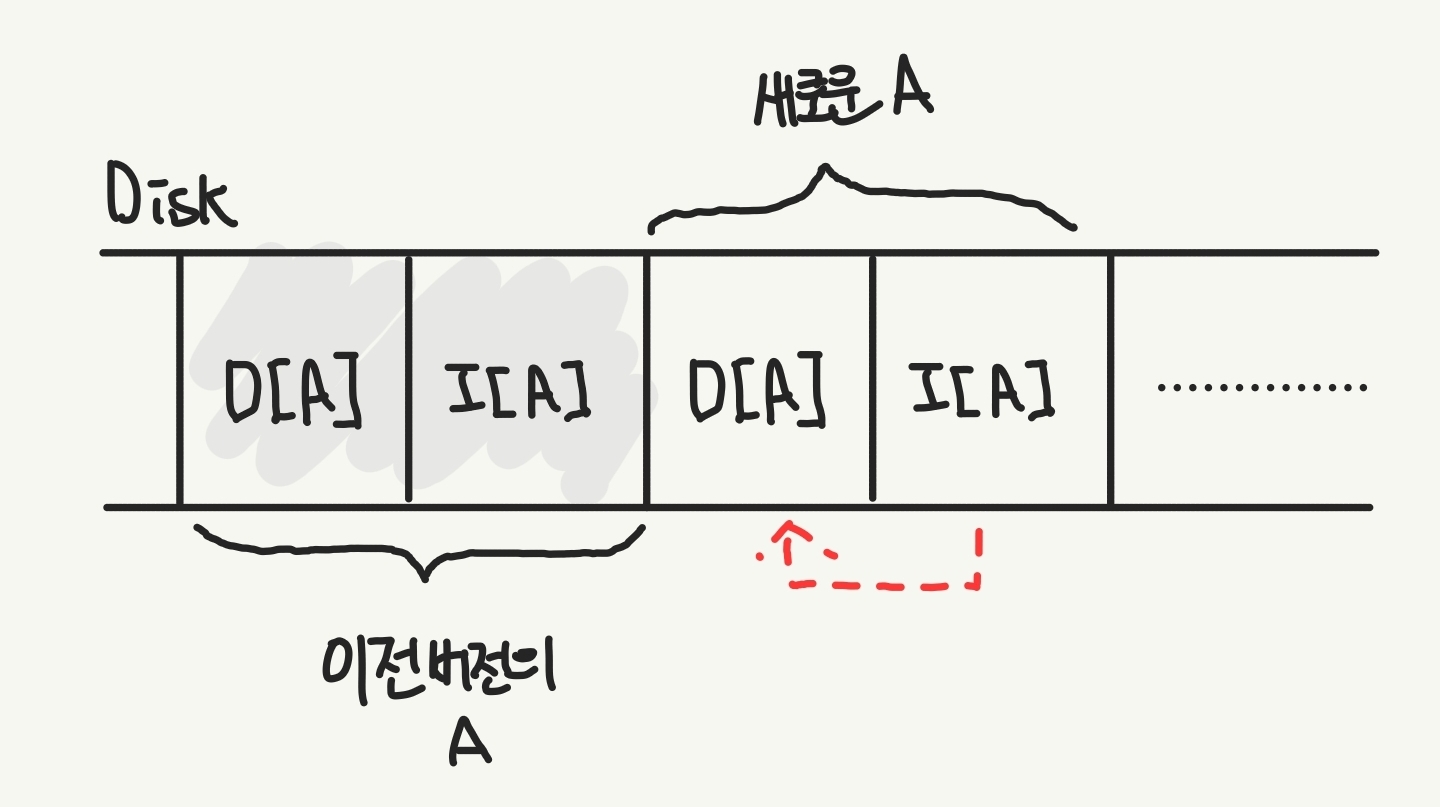
여기서 중요한 사실은, LFS는 파일 변경이 일어났을 때 이전 inode와 data block을 직접 수정하지 않는다는 것이다. 대신, LFS는 다음과 같이 새로운 inode와 data block을 바로 뒤에 이어 쓴다.
1-2. Buffering
그러나 만약 아무런 buffering 없이 파일을 저장한다면, 다음과 같은 문제가 생길 수 있다. 예를 들어, 파일 A와 B를 만드는 상황을 가정하자. 파일 A는 크기가 매우 커 3개의 data block을 사용하고, 파일 B는 크기가 상대적으로 작아 하나의 data block을 사용한다. 이 경우 LFS는 다음과 같이 파일을 저장할 것이다.
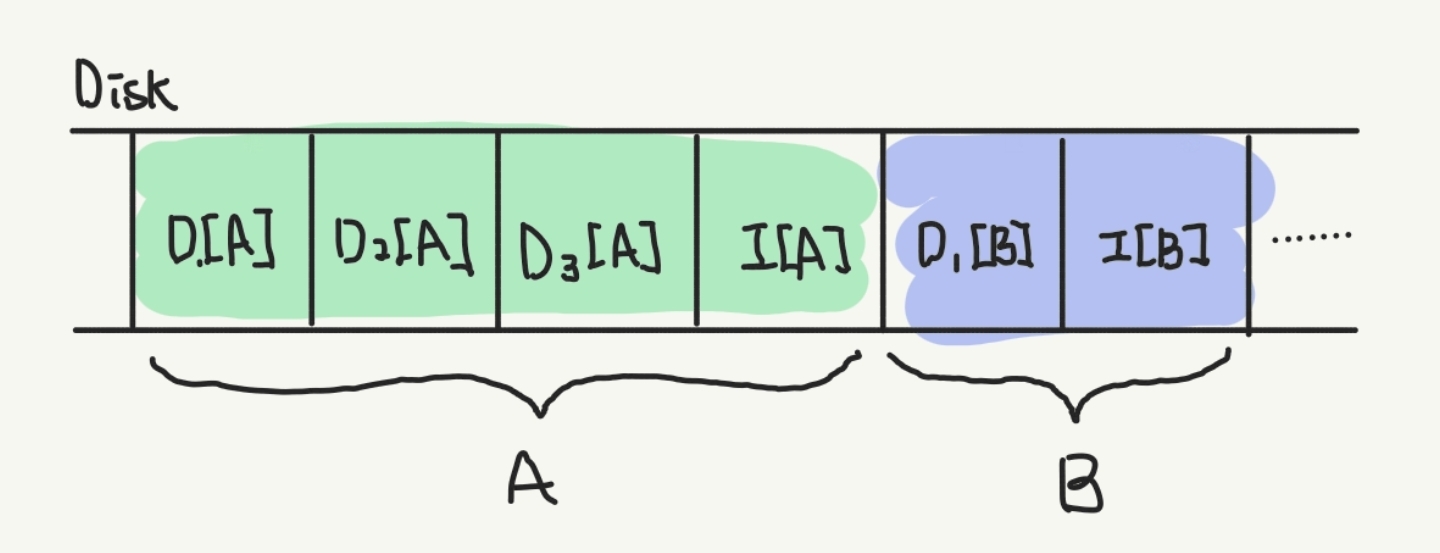
그러나 A 저장 직후에 B를 저장한다 하더라도, 디스크가 계속해서 돌고 있다는 점을 고려하면 B를 저장할 때의 디스크 모습은 다음과 같을 것이다.
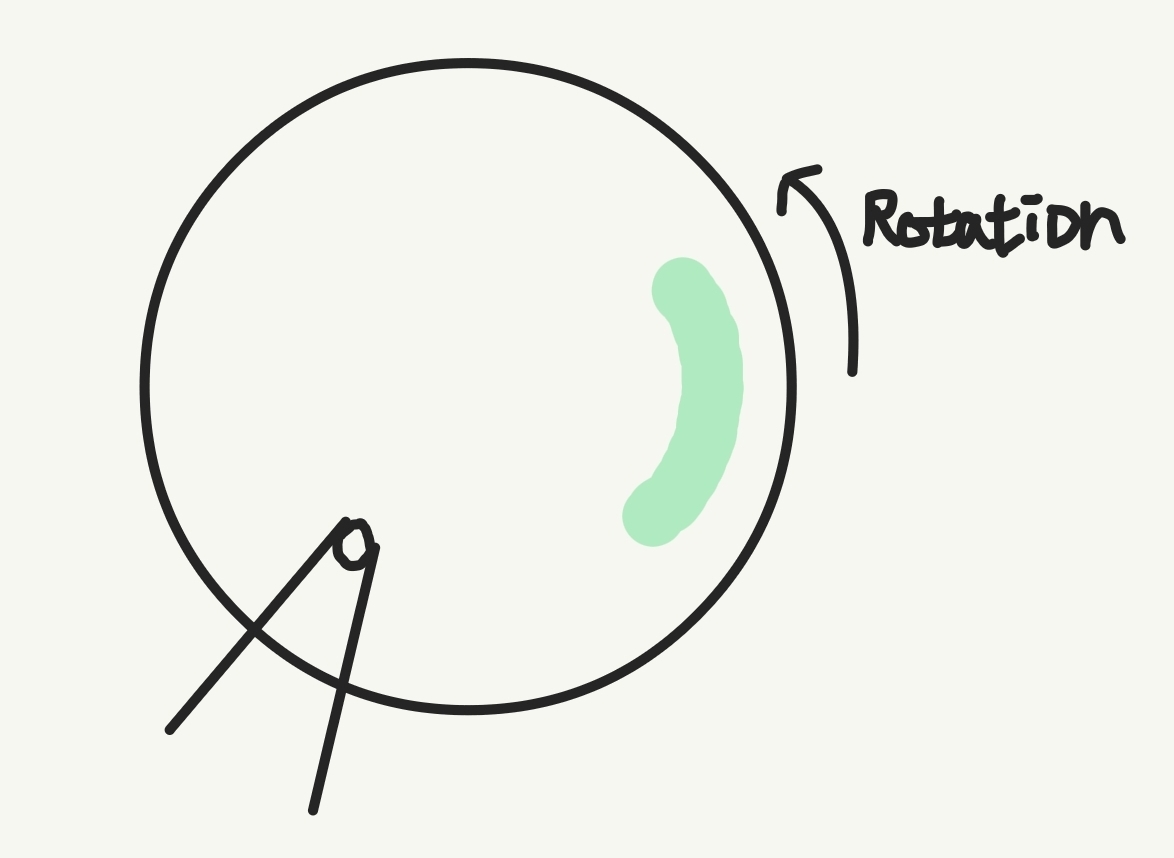
A 저장 후 rotation이 발생한 모습
따라서, B를 쓰기 위해서는 rotation이 일어나 disk head가 A 바로 뒤에 올 때까지 기다려야 하고, 이후에나 쓸 수 있게 된다.
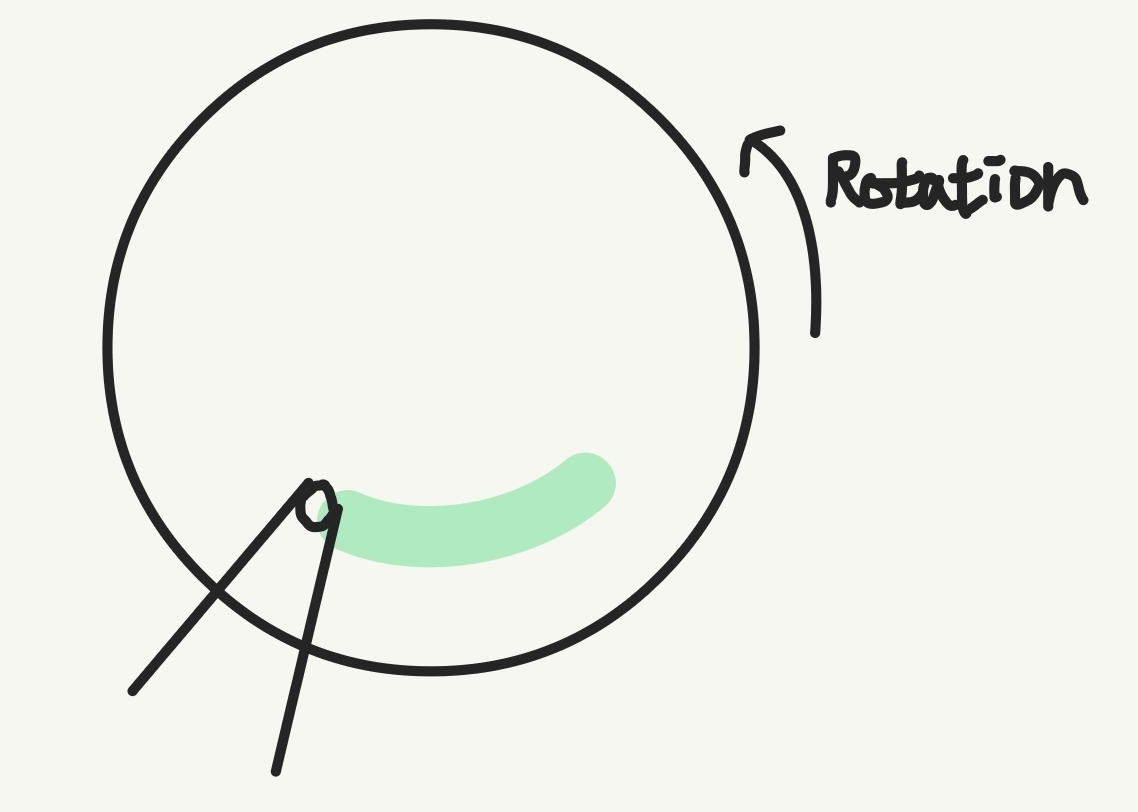
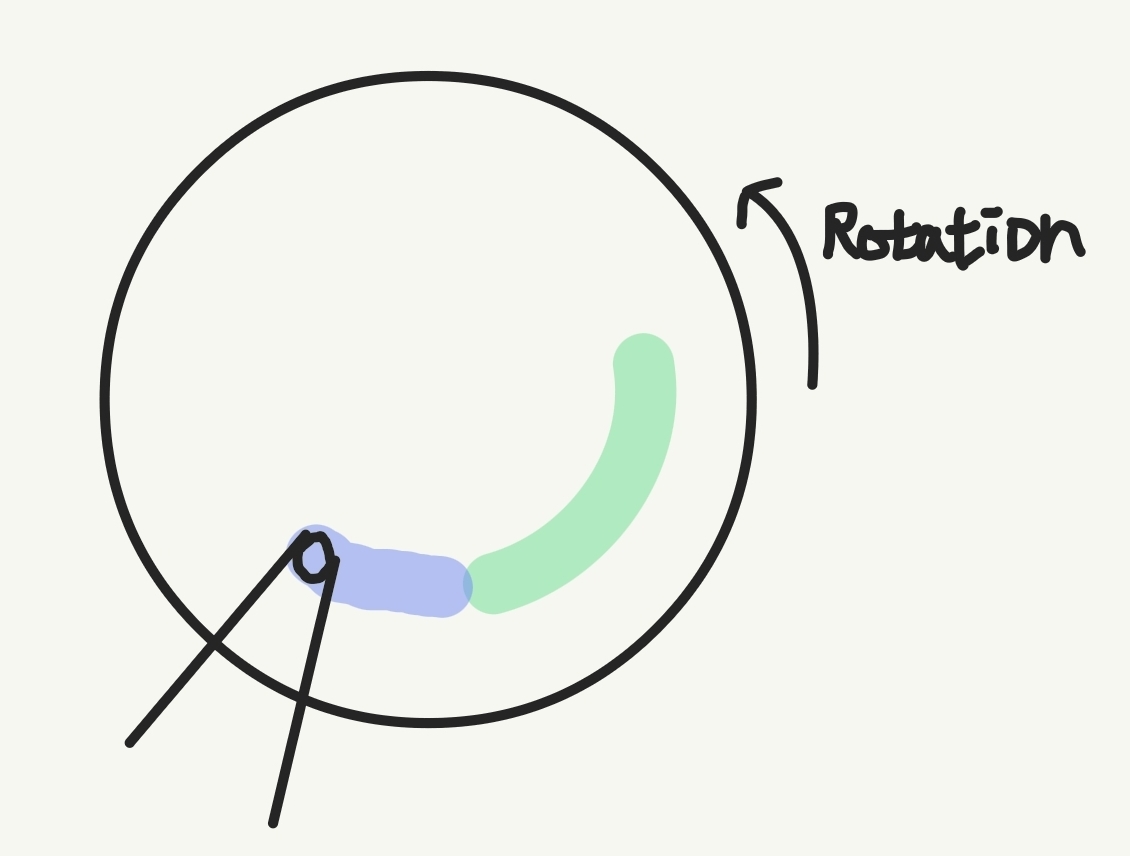
따라서 여기서는 seek이 일어나지 않아 seek time은 없지만, 여전히 rotational delay가 발생하기 때문에 sequential write의 속도를 완전히 사용할 수 없다. 따라서 이를 해결하기 위해 buffering이 사용된다.
LFS는 기본적으로 일정 시간(혹은 용량)동안 write 요청을 메모리에 저장해 두었다가, 모인 요청을 한꺼번에 디스크로 보낸다. 위 예시에서는 A가 만들어진 후 메모리에 저장되어 있다가, B가 만들어지며 A와 B가 한꺼번에 디스크에 전송되는 식이다. 이를 통해 rotational delay를 줄일 수 있고, 따라서 sequential write의 속도에 가까운 속도를 낼 수 있게 된다.
1-3. Amortization
최대 transfer rate를 $R_{peak}$이라 했을 때, $R_{peak}$의 $F\%$의 성능을 내기 위해서는 어떻게 해야 하는지 계산해보자. Buffer의 크기를 $D$라고 했을 때, write를 하는 데 걸리는 시간 $T_{write}$는
\[T_{write} = T_{position} + \frac{D}{R_{peak}}\]여기서 실제 데이터를 쓰는 데 걸리는 시간은, sequential write이기 때문에 $R_{peak}$으로 나눈다는 사실을 기억하자.
이를 통해 유효 transfer rate $R_{effective}$를 계산하면,
\[R_{effective} = \frac{D}{T_{write}} = \frac{D}{T_{position} + \frac{D}{R_{peak}}}\]이다. 이때, 우리는 원래 성능의 $F\%$만큼을 내고 싶다고 가정했기 때문에, 목표 성능 $R_{effective}=F \times R_{peak}$이다. 따라서 이를 우변에 두고 양변을 정리하면
\[\frac{D}{T_{position} + \frac{D}{R_{peak}}} = F \times R_{peak}\] \[\require{cancel} \begin{align} D &= F \times R_{peak} \times (T_{position} + \frac{D}{R_{peak}}) \\ &= (F \times R_{peak} \times T_{position}) + (F \times \cancel{R_{peak}} \times \frac{D}{\cancel{R_{peak}}}) \\ &= (F \times R_{peak} \times T_{position}) + (F \times D) \\ \end{align}\]이항하여 $D$에 대해 정리하면
\[\displaylines{ (1 - F) \times D = (F \times R_{peak} \times T_{position}) \\ \therefore D = \frac{F}{1-F} \times R_{peak} \times T_{position} }\]임을 알 수 있다.
3. Inode Maps (imap)
여기까지 오면, “특정 파일의 inode를 어떻게 찾을 수 있을까?”에 대한 의문이 당연히 들 수밖에 없다. 기존 파일 시스템의 경우는 inode가 저장되는 영역이 고정되어있었기 때문에 해당 영역을 탐색하면 됐었다. 그러나 LFS의 경우에는, inode가 디스크 전역에 흩뿌려져 있기 때문에 위치를 정확히 찾을 수가 없다. 이를 해결하기 위해, LFS는 inode map (imap)을 도입했다.
imap은 기본적으로 (inum, physical location) 쌍으로 구성된다. 간단히 말해서 imap은 결국 해당 inum을 가진 inode의 디스크상 실제 위치를 기록해 둔 것이라고 보면 된다. 예를 들어서, /A/B라는 파일이 있다고 가정하자. 이 경우 LFS는 디스크에 다음과 같이 저장할 것이다. (편의상 root directory는 생략했다. Root directory도 고려한다면 한 번의 imap 접근이 더 일어날 뿐 과정은 동일하다. 대신, root directory의 inum은 고정되어 있다는 점만 기억하자.)
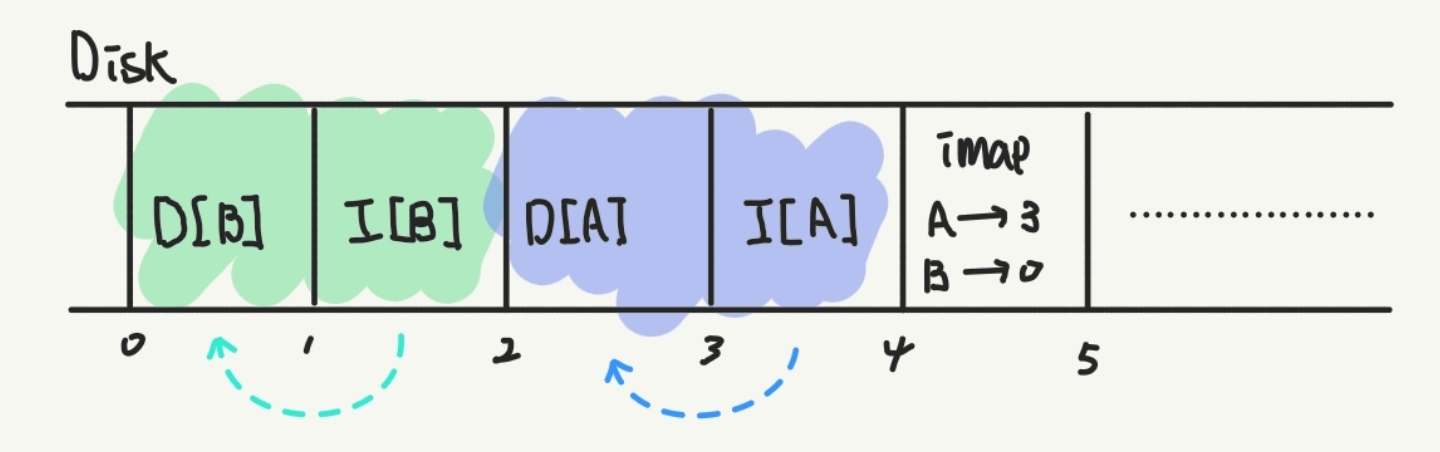
즉 OS는 다음과 같은 순서대로 파일에 접근할 것이다.
- 우선 imap을 읽어
A의 inode 위치를 가져와야 한다. (이때,A의 inum은 root directory로부터 알아낼 수 있었을 것이다.) - 알아낸
A의 inode 주소에 접근해 data block을 읽고,B의 inum을 알아낸다. B의 inum을 통해 imap으로부터Binode의 주소를 알아낸다.- 알아낸
B의 inode 주소에 접근해 데이터를 읽는다.
이때, imap의 디스크상 주소는 OS의 메모리에 저장되어 있기 때문에 OS는 언제든지 imap에 접근할 수 있다.
파일 B에 수정이 일어난다 하자. LFS는 B를 위해 새로운 inode와 data block을 할당받을 것이고, 이를 디스크에 기록할 것이다. 이후 만약 LFS가 A의 data block을 바꿔 새로운 B의 inode를 가리키게 하려고 한다면 A를 위한 inode와 data block도 새로 할당받아 저장해야할 것이다 (LFS는 절대로 data block을 수정하지 않고 완전히 새로 쓴다는 것을 기억하자). 이러한 경우 만약 /A/B/C/D/E/F/G/H같이 긴 경로의 파일을 수정할 때 overhead가 매우 커질 것이다 (이를 recursive update problem이라 한다). 따라서, LFS는 다음과 같이 imap만을 수정하게 된다.
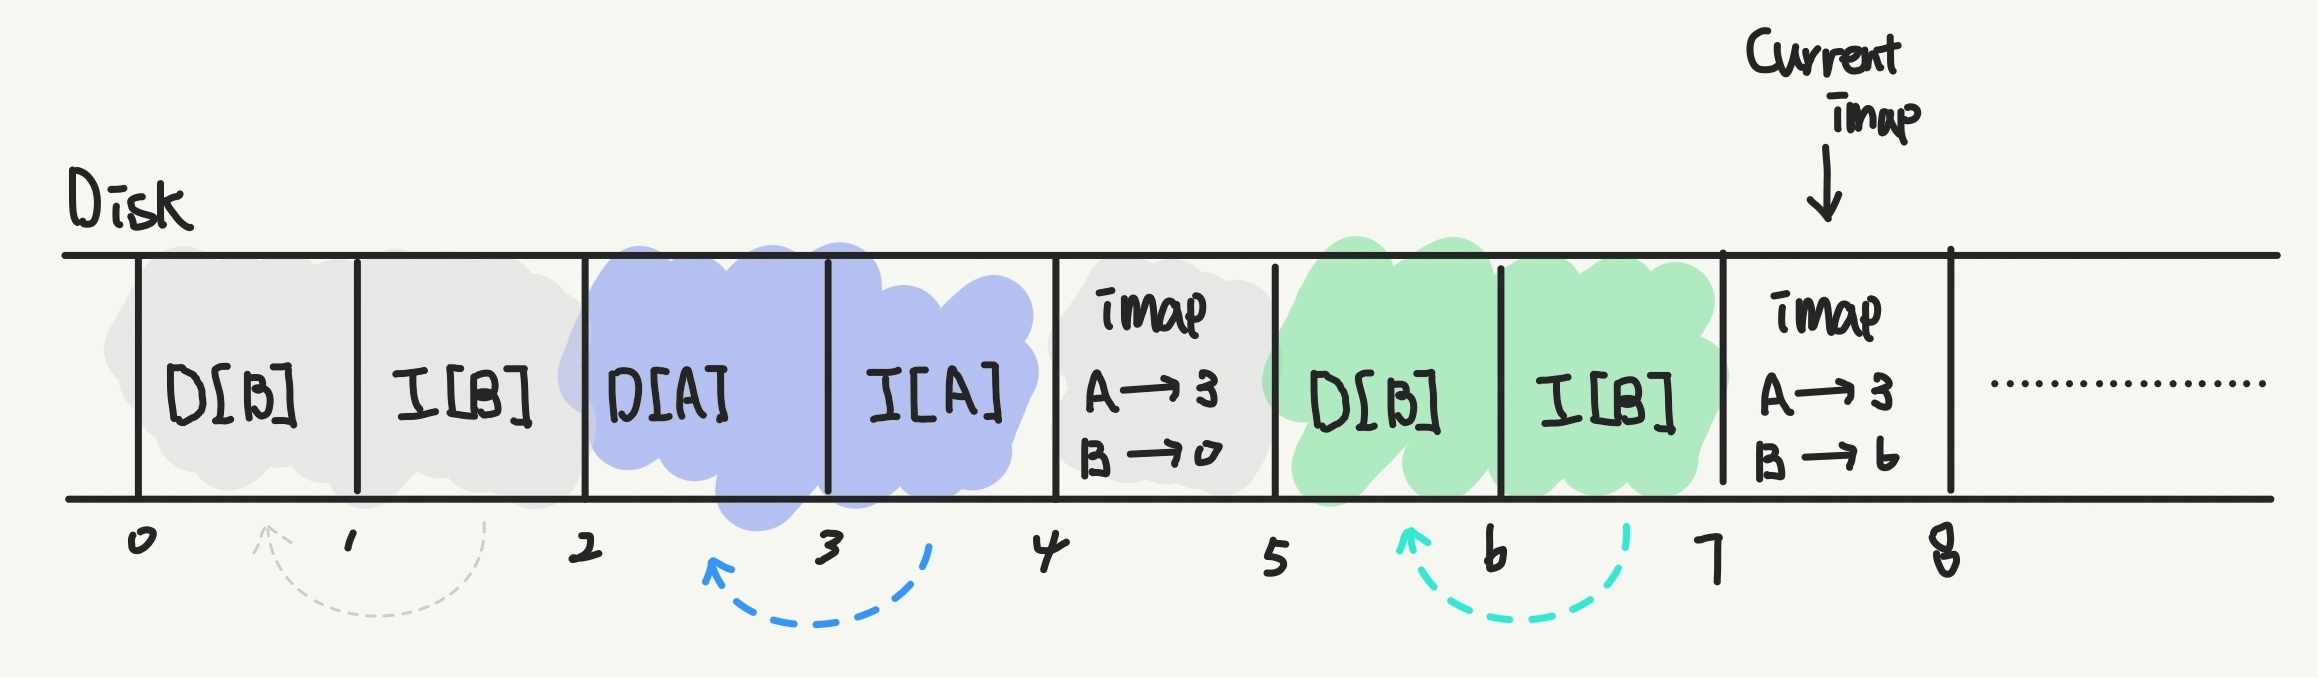
이렇게 되면, A를 전혀 수정하지 않고 imap만 수정해 같은 효과를 낼 수 있기 때문에 LFS는 이 방식을 사용해 recursive update problem을 해결한다.
4. Checkpoint Region (CR)
그러나 현재 imap의 위치는 메모리에만 저장되어 있기 때문에, 만약 시스템의 전원이 꺼진다면 다음 부팅 시 OS는 imap의 위치를 알 수 없게 된다. 따라서 imap의 위치도 디스크에 저장되어야 하고, LFS는 항상 고정된 위치에 다른 파일 시스템의 superblock과 비슷한 Checkpoint Region (CR) 영역을 만들어 imap의 위치를 저장하게 된다. 이를 통해, OS가 재부팅되더라도 CR 영역을 읽어 imap의 위치를 알 수 있게 된다.
이때, 만약 imap이 갱신될 때마다 CR도 갱신하게 된다면 상당히 큰 overhead가 발생하게 될 것이다 (CR은 고정된 위치에 있기 때문에 random access나 마찬가지다). 이를 해결하기 위해, LFS는 기본적으로 imap 위치를 잠시 caching해 뒀다가 일정 주기로 (혹은 disk I/O가 없을 때) CR을 업데이트하는 식으로 동작하게 된다.
만약 디스크에 데이터를 쓰는 도중, CR이 갱신되지 않은 상태에서 crash가 발생된다면 OS는 다음 부팅 시 이전 버전의 imap을 보고 있기 때문에 사용자가 쓴 데이터가 모두 소실되겠지만, 파일 시스템의 consistency에는 영향을 미치지 않을 것이다. 그러나 CR 갱신 도중 crash가 발생된다면 consistency에 영향을 미치기 때문에, LFS는 다음과 같은 방식을 통해 atomicity를 보장한다.
- CR을 디스크의 맨 앞과 뒤에 2개 만든다.
- CR을 업데이트할 때, 우선 디스크의 앞쪽 CR을 업데이트한다. 이때
TxB,TxE와 비슷하게 CR 앞쪽에 시작 시간의 timestamp를 남기고, 쓰기가 완료된 후 뒷쪽에도 완료 시간의 timestamp를 남긴다. - 앞쪽의 CR이 업데이트되면 디스크의 뒷쪽 CR을 업데이트한다. 마찬가지로 timestamp를 남긴다.
만약 CR을 업데이트하는 도중 crash가 발생했다면, 시작 시간의 timestamp가 완료 시간의 timestamp보다 뒤의 시간대일 것이다. 이를 통해 LFS는 해당 CR이 잘못되었음을 파악할 수 있고, 따라서 다른 CR을 사용해 오류를 복구할 수 있게 된다.
5. Garbage Collection (GC)
앞선 상황을 다시 한 번 살펴보자.
위 상황에서, 0번~1번 block과 4번 block은 더 이상 쓰이지 않는 block이고, 따라서 디스크에서 지워져야 한다. 물론 해당 block들을 남겨놓고 나중에 파일을 이전 버전으로 되돌리고 싶을 때 사용자가 되돌릴 수 있게 하는 기능으로도 사용할 수 있겠지만, 디스크의 용량은 무한하지 않기 때문에 결국 언젠가는 디스크에서 지워져야 한다. 이렇게 더 이상 사용되지 않는 block들을 garbage라 부르고, 해당 block들을 지우는 과정을 garbage collection이라 부른다.
이때 LFS는 해당 블럭이 사용되는지 사용되지 않는지를 알아보기 위해 segment summary block를 만든다. 기본적으로 해당 block은 segment의 맨 앞에 있으며, segment 안에 있는 block들의 inum과 inode상 offset(multi-level indexing)를 저장하고 있다. 따라서 다음과 같은 방식으로 해당 block이 garbage인지 판단할 수 있다. (여기서는 inode가 단일 data block을 사용한다고 가정한다.)
// block A
inum = segment_summary[A];
inode = imap[N];
if (inode->data_block != A) {
  mark(A, GARBAGE);
  clean(A);
}
GC는 굉장히 무거운 작업이기 때문에, 항상 일어나는 것이 아니라 특정 주기를 두고 disk I/O가 많이 없거나 용량이 부족해 꼭 필요한 경우 일어나게 된다. 현대 LFS는 이를 더욱 최적화하기 위해 segment를 hot segment와 cold segment로 나누는 등 여러 방법이 사용되고 있다.
Leave a comment