[CS][OS] Persistence - Crash Consistency
이 글은 Andrea Arpaci-Dusseau and Remzi Arpaci-Dusseau의 Operating Systems: Three Easy Pieces를 참고한 글입니다.
여기에서 무료로 볼 수 있습니다.
0. Introduction
I/O 작업을 하다 보면, 여러 가지 문제가 생길 수 있다. 예를 들어, 파일을 만든 후 내용을 쓰는 작업을 하던 도중 OS가 갑자기 멈춘다 생각해 보자. 파일 시스템마다 다르겠지만, OS가 파일의 inode만 만들었다면 해당 파일은 쓰레기 값을 가질 것이다(data block에 쓰지 않았으므로). 만약 directory에 해당 inode에 대한 entry를 만들지 않았다면, 해당 inode는 inode bitmap상 존재하지만 접근할 수 없는 상태가 될 것이다. 물론 소프트웨어적인 문제뿐만 아니라 하드웨어적인 문제도 생길 수 있다. 예를 들어, 갑작스러운 정전으로 인해 쓰기 중이던 디스크에 전원이 끊기는 현상이 있을 수 있다.
이러한 경우에서도, OS 안정적으로 동작해야 한다. 이를 OS의
Crash Consistency
라고 한다.
1. Scenarios
우선, 문제 상황을 살펴봐야 한다. 설명을 위해 파일 A를 업데이트하는 중이라고 하자. 즉, A는 이미 inode와 data block을 가지고 있는 상태이다. 또한 해당 업데이트는 기존에 할당받은 data block을 수정하는 대신, 새로운 data block을 할당받고 여기에 업데이트된 내용을 쓴 후 A의 inode가 새로운 data block을 가리키도록 수정하는 식으로 일어난다 하자. 이때, A의 inode를 I[A], data를 D[A], 새로 업데이트된 data block을 D[A]'라 하자. 마찬가지로 A의 data bitmap을 DB[A]라 하자. 이러한 경우에서, 문제 상황은 다음과 같이 나눌 수 있다.
D[A]'만 쓰인 경우
이 경우는 큰 문제가 되지 않는다. 물론 사용자는 자신이 쓰고 있던 데이터 전부를 잃고 수정 전으로 돌아간것이나 마찬가지지만(이 data block에 접근할 수 있도록 하는I[A]가 업데이트되지 않았기 때문에), 이 block은 빈 block과 마찬가지이기 때문에 consistency 관점에서는 문제가 아니다.I[A]만 업데이트된 경우
이 경우는 매우 심각하다.I[A]가 새로운 data blockD[A]'를 가리키고 있지만,D[A]'에는 아직 업데이트가 일어나지 않은 상태이다. 따라서A의 data는 쓰레기 값을 가지거나(만약D[A]'를 이전에 사용한 적이 있다면), 비어 있을 것이다. 또한DB[A]상에서D[A]'은 해제된 block이기 때문에 만약 다른 I/O 작업에 의해D[A]'가 사용된다면 파일의 내용을 잃게 될 것이다. 또한 이제D[A]는 실제로는 아무도 사용하고 있지 않지만DB[A]상에서 사용된다고 표시되어 있기 때문에, 영원히 해제가 일어나지 않고 따라서 memory leak처럼 저장공간에서의 leak이 발생하게 될 것이다.DB[A]만 업데이트된 경우
이 경우는 매우 심각하다.DB[A]상으로D[A]는 사용하지 않는 block이고,D[A]'은 사용하는 block일 것이다. 그러나 실제로I[A]는D[A]를 가리키고 있기 때문에, 만약 다른 I/O 작업에 의해D[A]가 덮어씌워진다면 사용자는 파일의 내용을 잃게 될 것이고, 해당 파일은 다른 파일과 동기화되어있는 것처럼 보일 것이다. 또한D[A]'는 영원히 해제되지 않을 것이다.I[A],DB[A]만 업데이트된 경우
이 경우는 큰 문제가 되지 않는다. 사용자는 마찬가지로 자신이 쓴 데이터 대신 쓰레기 데이터를 얻겠지만, 2번과 3번 경우처럼 leak이 발생하지는 않고 consistency 관점에서는 문제가 아니다.I[A],D[A]'만 업데이트된 경우
이 경우는 심각하다. 사용자 입장에서 잠깐 동안은 파일에 내용이 제대로 기록되어 있기 때문에 괜찮다고 생각할 수 있다. 그러나DB[A]가D[A]는 할당되었고D[A]'는 해제된 상태로 표시하고 있기 때문에 마찬가지로D[A]에 대한 leak이 발생하게 될 것이다. 또한 다른 I/O 작업에 의해D[A]'가 덮어씌워진다면 사용자는 파일의 내용을 잃게 될 것이다.D[A]',DB[A]'만 업데이트된 경우
이 경우는 심각하다. 우선 사용자 입장에서는 파일에 대한 수정사항을 모두 잃고 원래 상태인D[A]로 되돌아왔다고 생각할 것이다. 또한DB[A]상D[A]는 해제되었고D[A]'는 할당된 상태로 표시하고 있기 때문에D[A]'에 대한 leak이 발생하게 될 것이다. 또한 다른 I/O 작업에 의해D[A]가 덮어씌워진다면 사용자는 파일의 내용을 잃게 될 것이다.
따라서 우리는 concurrency 문제에서 봤던 것처럼 D[A], I[A], DB[A]를 atomic하게 처리해야 한다고 생각할 수 있다. 그러나 이는 쉽지 않은데, disk I/O는 시간이 많이 들 뿐더러 정전으로 인한 전원이 끊기는 상황과 같은 문제들은 어느 시점에서나 랜덤하게 일어날 수 있는 문제이기 때문이다. 따라서 atomic하게 처리하는 방법 대신 다른 방법을 생각해야 한다.
2. File System ChecKer (FSCK)
앞서 살펴본 상황을 해결하기 위해 생각해볼 수 있는 것은 “오류가 일어나도록 내버려두고 시스템이 재부팅될 때 오류를 해결하는 방법”이다. 이를 위해 UNIX에서는 fsck라는 도구를 제공하고, 이와 비슷하게 Windows에서는 chkdsk를 제공한다. 여기서는 fsck를 알아보도록 한다.
fsck는 기본적으로 파일 시스템이 mount되기 전 동작하며, fsck가 동작하는 동안 아무런 활동도 일어나지 않는 것을 전제로 한다. fsck는 다음과 같은 역할을 수행한다.
- Superblock 확인
fsck는 우선 superblock의 무결성을 검증한다. 여기에는 현재 할당된 block의 전체 크기보다 파일 시스템 전체의 크기가 더 크다는 것을 확인하는 등 여러 과정이 들어간다. 만약 superblock이 손상되었다면, 같은 디스크에 저장된 다른 superblock을 대신 쓰는 것을 고려할 수 있다 (앞서 FFS는 여러 개의 superblock을 저장하고 있다고 말했었다*). - Block 해제
다음으로 모든 inode를 훑어 현재 사용되고 있는 data block이 무엇들인지 파악한다. 만약 사용되지 않는 data block이 bitmap에 사용중이라고 표시되어 있다면, 해당 block을 해제하고 data bitmap을 업데이트한다. 마찬가지로 inode bitmap도 수정한다. 여기서 중요한 것은 fsck는 앞선 1번과 4번 경우처럼 사용자가 쓰레기 값을 읽게 되는 문제를 해결하지는 않는다는 것이다. fsck는 오로지 파일 시스텡의 consistency만을 보장하는 것을 목표로 하기 때문이다. - Inode 확인
다음으로 fsck는 inode의 link 개수를 확인한다. 여기서 link 개수란, 몇 개의 directory가 해당 inode를 참조하고 있는지에 대한 수이다. 이를 검증하기 위해 fsck는 root directory인/부터 traverse를 진행하여 전체 inode에 대한 실제 link 수를 다시 계산한다. 만약 다시 계산한 link 수와 inode에 쓰인 link 수가 맞지 않는다면, inode의 link수를 수정해 맞도록 한다. 만약 link수가 0인 inode가 존재한다면 이는 leak된 inode이고, fsck는 이를lost+founddirectory로 옮긴다.
또한 이 과정에서 fsck는 inode가 손상되지 않았는지(예를 들어,type필드에 적절한 값이 들어가 있는지, inode가 참조하고 있는 data block이 실제 data block의 range를 넘지는 않았는지 등)를 검사한다. 만약 inode가 손상되었다면, fsck는 이 inode를 해제하고 inode bitmap을 업데이트한다. - 다중 참조 검사
앞선 과정의 연장선으로, fsck는 한 data block이 여러 inode에 의해 reference되고 있는지도 검사한다. 만약 여러 개의 inode에 의해 다중으로 참조하고 있는 data block이 발견된다면, fsck는 해당 data block을 복제한 후 이를 참조하고 있는 inode를 새로 복제된 data block을 참조하도록 설정한다. 그러나 만약 다중 참조하고 있는 inode중 손상된 inode가 있다면, fsck는 data block을 복제하는 대신 해당 inode를 잘못된 것으로 판단하고 삭제한다. - Directory 검사
마지막으로 fsck는 directory들을 검사한다. 이 과정에서, 각각의 directory에.과..에 대한 entry가 존재하는지,(name, inum)쌍에서 참조하고 있는 inum의 inode가 실제로 존재하는지 등이 검사된다.
이러한 과정을 통해 fsck는 파일 시스템의 무결성을 보장하게 된다. 그러나 쉽게 추측할 수 있듯, fsck는 무결성 보장을 위해 root directory부터 traverse를 진행하기 때문에 파일이 많아지면 많아질수록, 디스크 용량이 커지면 커질수록 굉장히 시간이 많이 걸리게 된다. 따라서 fsck를 대체할 수 있는 새로운 방법이 필요하게 되었다.
3. Journaling
fsck의 문제를 해결하기 위해 나온 것이 journaling이다. 이는 실제로 Windows의 NTFS, Linux의 et3/ext4등 여러 파일 시스템에서 채택되어 사용되고 있는 방법이다.
Journaling은 write-ahead logging이라고도 불리며, 기본적으로 disk I/O를 실행하기 전 특정 형식으로 log를 남겨놓음으로써 파일 시스템의 consistency를 보장하는 방법이다. 이렇게 실제 disk I/O를 수행하기 전 로그를 남겨놓기 때문에 실제 disk I/O 중 오류가 발생하더라도 안전하게 해당 disk I/O가 일어나기 전으로 되돌어갈 수 있다.
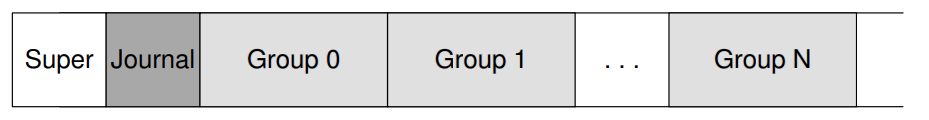
Journaling을 위해서는 disk I/O에 대한 log를 저장할 공간이 추가로 필요하게 된다. 이를 위해 파일 시스템은 위와 같이 디스크의 특정한 group을 Journal Block으로 지정해 여기에 로그를 기록하게 된다.
참고
이제부터 한 번의 disk I/O가 일어날 때 남겨지는 log를 journal이라고 부를 것이다. 즉, journal block은 여러 개의 journal로 이루어져 있다.
3-1. Data Journaling
3-1-1. Journal Writing and Commiting
journal은 다음과 구성된다.
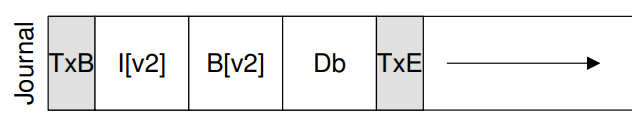
TxB(Transaction Begin Block): Journal의 시작점을 알린다. 이 블럭은 journal 대한 정보(길이,TID(Transaction ID)등)를 담고 있다.Data: 어떤 정보가 disk에 기록될지에 대한 정보이다. 여기에는 inode, bitmap, data block등이 들어갈 수 있다.TxE(Transaction End Block): Journal의 끝점을 알린다.
참고
위의 방법은 journal 자체가 파일에 대한 정보를 모두 담고 있고 이를 physical logging이라 부른다. 반대로, 파일에 대한 전체 정보 대신 “어떤 변경을 했는지”에 초점을 두는 로그를 logical logging이라 한다.
그러나 journal도 결국 디스크의 journal group에 저장되는 것이기 때문에, journal이 저장되는 도중 오류가 발생하는 경우도 배제할 수 없다. 만약 크기가 상대적으로 작은 TxB와 TxE는 모두 저장되었는데, Data가 모두 저장되지 못하면 어떻게 될까? 이런 경우에서는 journaling이 제대로 작동하지 못할 것이다.
이를 해결하기 위해 journaling에서는 journal를 기록할 때 TxB, Data를 먼저 기록하고 이들이 전부 기록된 후에 TxE를 쓴다. 이렇게 되면, journal을 읽을 때 TxE가 없다면 해당 journal은 불완전한 journal이기 때문에 해당 journal 전체를 무시할 수 있게 된다. 이렇게 TxB, Data를 쓰는 작업을
Journal Write
라고 부르고, journal write가 끝난 후 TxE를 쓰는 작업을
Journal Commit
이라고 부른다.
참고
물론TxE가 기록되는 도중에 오류가 발생할 수도 있지만, 현대 디스크는 일정 크기에 대한 write(보통 block 단위이다)에 대해서는 atomicity를 보장하고, 따라서TxE를 기록하는 도중 오류가 발생한다면 다시 journal을 읽을 때TxE는 애당초 기록되지 않은 상태가 될 것이다.
3-1-2. Checkpointing
Journal이 안전하게 저장되고 나면(즉, journal commit이 끝나고 난 후), 파일 시스템은 이제 실제로 bitmap을 수정하고, inode를 할당/수정하고, data block을 할당받고 수정하는 등 실제 파일이 저장된 영역을 수정해야 한다. 이를 checkpointing이라 한다. Checkpointing이 완전히 수행되었다는게 확인되면, 해당 transaction에 대한 journal은 삭제된다.
3-2. Recovery
이제 앞서 살펴봤던 문제상황에서 journaling이 어떻게 동작하는지 살펴보자.
만약 journal write 도중 crash가 발생했다면, 앞서 말했던 것처럼 해당 journal은 버려지게 된다. 이로 인해 사용자는 자신이 썼던 데이터를 모두 잃어버리겠지만, consistency에는 영향을 미치지 않는다. 실제 파일시스템은 전혀 바뀌지 않았기 때문이다. 그러나 journal commit이 발생하고 나서 checkpointing이 진행되는 도중 crash가 발생하면 어떻게 될까? 이 경우에는, 기록된 journal을 참고해 오류 복구를 시도해볼 수 있다. 즉, journal group에 저장된 journal들을 모두 다시 실행한다는 것이다.
예를 들어, 파일 A를 새로 만드는 과정을 생각해 보자. Journal commit이 일어난 이후, checkpointing중 bitmap을 수정하는 과정에서 crash가 발생해 시스템이 재부팅되었다고 하자. 이때 journal은 부팅 이후 journal group에 A에 대한 journal이 있는 것을 확인할 것이고, 해당 journal이 유효한지 검사할 것이다. 여기서는 Journal commit이 일어난 상황을 가정했기 때문에, 올바른 TxE가 저장되어 있을 것이고 따라서 시스템은 해당 journal에 기록된 모든 과정을 다시 수행한다. 즉, inode를 다시 할당받는 과정부터 다시 모든 과정을 반복한다는 것이다. 이후, 해당 journal은 journal group에서 삭제된다. 이를 통해, 파일 시스템의 consistency를 보장할 수 있다.
3-2. Metadata Journaling
앞서 본 방법은 journal commit 과정까지 일어나면 데이터 손실의 위험이 거의 0%이기 때문에 안전하지만, 데이터가 디스크에 두 번 쓰인다는 문제점이 있다. 예를 들어, 10GB짜리 큰 파일을 디스크에 저장할 때, 실제로 디스크는 해당 파일의 내용을 journal에 한 번, 실제 data block에 한 번 쓰기 때문에 20GB를 쓰는 것이나 마찬가지라는 것이다. 이를 해결하기 위해 파일의 data 기록 없이 metadata(inode, bitmap)만을 journal에 기록하는 방식이 등장했고, 이를 metadata journaling 혹은 ordered journaling이라 한다.
이 방법은, 다음과 같은 순서로 동작한다.
- Data block을 실제 파일 시스템 영역에 기록함과 동시에(이때, data block bitmap은 수정되지 않는다!) journal write를 수행한다. 이때, 해당 journal에는 inode, inode bitmap, data block bitmap만 저장된다.
- Data block에 대한 쓰기 작업과 journal write가 끝난 이후, journal commit을 수행한다.
- Checkpointing을 수행한다. 이때, data block은 1번 과정에서 이미 기록했기 때문에 journal에 저장된 metadata만 저장한다.
- 해당 journal을 삭제한다.
여기서 data block을 journal write보다 먼저 쓰는 이유는, 쓰레기 데이터를 가리키는 상황을 방지하기 위해서이다. 만약 journal write와 journal commit이 data block을 쓰기 전 수행되고 이어서 data block 쓰기가 수행된다면, data block이 쓰이는 도중 crash가 발생한다면 journaling은 metadata만 복원하기 때문에 해당 파일은 쓰레기 데이터를 가리킬 수 있다. 그러나 data block을 먼저 기록함으로써 journal에 저장된 inode가 가리키는 data block에는 실제 해당 파일의 data가 들어있음을 보장할 수 있게 된다.
3-3. Revoke
그러나, 다음과 같은 상황을 생각해 보자.
- Directory A가 수정된다. 이때, directory는 metadata로 분류되기 때문에 파일 시스템은 해당 directory의 data block도 journal에 기록한다. Directory A는 data block #1000을 쓰는 중이라 가정해 보자.
- Directory A가 지워진다. 이에 따라 data block #1000은 해제된다.
- File B가 생성된다. 이 파일은 data block #1000을 재할당받는다. 이후 journal commit이 일어난다.
- Crash가 일어나고, journal은 그대로 남아 있다.
이 상황에서 journal을 XML로 간략하게 표현해 보면 다음과 같을 것이다.
<TxB TID=1>
  <Inode of='A'>...</Inode>
  <Data num=1000>...</Inode>
<TxE TID=1>
// Directory A가 지워진다.
// 여기서 data block #1000은 새로운 데이터로 덮어씌워진다.
<TxB TID=2>
  <Inode of='B'>...</Inode>
  <InodeBitmap>...</InodeBitmap>
  <DataBitmap>...</DataBitmap>
<TxE TID=1>
이제 journal replay가 실행된다. TID=1인 journal에 의해 data block #1000은 기존의 directory data로 덮어씌워질 것이다. 다음으로 TID=2인 journal에 의해 새로 만든 B는 복구되지만, data block의 내용은 앞서 TID=1인 journal이 replay되며 덮어씌워졌기 때문에 데이터가 전부 손실되었다.
이러한 상황을 막기 위해, journaling에는 revoke라는 기능이 있다. 특정 journal에 revoke 표시를 해 두면, 해당 journal은 replay되지 않게 된다. 즉,
<TxB TID=1 revoke> // Directory A가 지워지며 revoke 표시가 붙는다.
  <Inode of='A'>...</Inode>
  <Data num=1000>...</Inode>
<TxE TID=1>
// Directory A가 지워진다.
// 여기서 data block #1000은 새로운 데이터로 덮어씌워진다.
<TxB TID=2>
  <Inode of='B'>...</Inode>
  <InodeBitmap>...</InodeBitmap>
  <DataBitmap>...</DataBitmap>
<TxE TID=1>
이러한 상황에서, journal replay가 실행되더라도 TID=1인 journal이 replay되지 않으면서 앞서 생겼던 문제가 해결되게 된다.
참고
앞서 revoke의 필요성에서, “directory의 data block을 저장 안 하면 되는 거 아니야?”라는 의문이 들 수도 있다. 그러나 directory의 data block을 저장하지 않으면 큰 문제가 발생할 수 있다. 다음 상황을 생각해보자.
- 사용자가
A/B.txt를 생성한다.A는 data block #100을 사용 중이고,B.txt는 data block #200을 사용하게 된다고 가정하자. - OS는
B.txt가 사용할 inode와 data block을 정한다. 이후 OS는B.txt의 data block과A의 data block에 대한 쓰기 요청을 날림과 동시에 journal write를 시도한다. A의 data block에 대한 write가 끝난 직후 crash가 발생하고, journal commit이 일어나지 않는다.
이 시점에서 journal은 다음과 같을 것이다.
<TxB TID=1>
  <Inode of='A'>...</Inode>
  <Inode of='B.txt'>...</Inode>
  <InodeBitmap>...</InodeBitmap>
  <DataBitmap>...</DataBitmap>
해당 journal에는 <TxE>가 없기 때문에, 이 journal은 replay되지 않는다. 그러나, 이미 A의 data block은 수정된 상태이므로 A는 실제로는 존재하지 않는 파일인 B.txt를 가리키게 된다.
따라서 이런 문제를 해결하기 위해 directory의 data는 journal에 쓰인다. 만약, directory의 data가 journal에 쓰인다면, A의 data block은 checkpointing이 일어나는 시점에서 수정되기 때문에 안전하게 수정될 수 있다.
Leave a comment