[CS][OS] Persistence - File System
이 글은 Andrea Arpaci-Dusseau and Remzi Arpaci-Dusseau의 Operating Systems: Three Easy Pieces를 참고한 글입니다.
여기에서 무료로 볼 수 있습니다.
0. Introduction
OS가 디스크에 파일을 기록할 때, 아무런 체계 없이 데이터를 대충 디스크에 기록한다면 나중에 데이터를 다시 읽어오거나 찾아야 할 때 문제가 발생할 것이다. 따라서 OS는 어떤 방식으로 데이터를 배치하고 관리할지에 대한 체계가 필요하고, 이를
File System
라고 부른다. 이 글에서는 VSFS(Very Simple File System)과 FFS(Fast File System)을 살펴본다.
1. Very Simple File System (VSFS)
1-1. Layout
우선, VSFS는 디스크를 block이라는 논리적 단위로 나눈다. 각 block은 고정된 크기를 가지고 있으며, 보통 4KB의 크기를 갖는다. 여기서는 예시를 위해, 64개의 block이 존재하는 256KB 디스크를 생각하자.
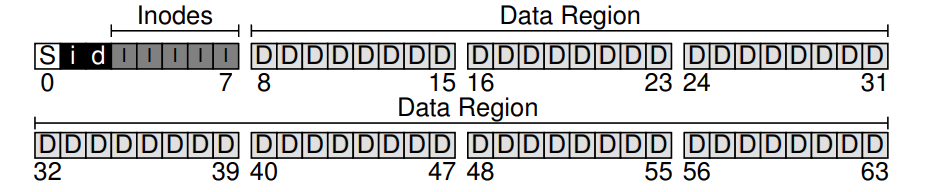
해당 디스크에는 데이터가 저장되어야 하기 때문에, block중 대다수는 실제로 데이터가 저장되는 영역일 것이다. 여기서는 예시로 56개의 block(224KB)이 data를 담는 영역이라고 생각하자(위 그림에서 D로 표시된 영역이 데이터가 저장되는 영역이다).
이제 저장된 데이터에 대한 정보가 저장될 공간도 예약해둬야 한다. 즉, 특정 데이터 블록에 어떤 데이터가 저장되어 있는지, 만든 시각과 마지막으로 수정한 시각이 언제인지, 파일 소유자는 누구인지 등의 정보가 저장될 공간도 필요하다는 것이다. 이렇게 파일 자체의 데이터 외적인 정보를
Metadata
라고 하며, 파일 시스템은
Inode
를 사용해 파일의 metadata를 저장한다.
파일의 metadata로 무엇을 담냐에 따라 다르지만, 보통 inode 하나는 256B정도의 크기를 갖는다. 여기서는 예시로 inode에 5개의 블럭을 할당했고, 따라서 80개의 inode(4KB * 5 / 256b = 80)을 사용할 수 있다. 위의 그림에서 I로 표현된 영역이 inode 영역이다. 앞으로 해당 영역을 inode table이라 부르기로 하자.
또한 어떤 inode 블럭과 data 블럭이 사용중인지에 대한 정보도 필요하다. 보통 bitmap으로 표현되며, 이를 위해 각각 한 블럭씩을 할당해 관리한다. (물론 inode는 80개이므로 80bit, data는 56개이므로 56bit만 필요하겠지만 여기서는 설명의 편의를 위해 4KB 전체를 각각 사용하는 것으로 했다.) 위의 그림에서 i가 inode bitmap, d가 data bitmap이다.
마지막으로, 해당 디스크에 대한 정보를 담고 있는 공간도 필요하다. 이를
Superblock
이라고 하며, 해당 디스크가 어떤 파일 시스템을 사용중인지, 얼마나 많은 inode와 data block이 존재하는지 등에 대한 정보를 담고 있다.
1-2. Inode
앞서 말한 inode는, data region의 블럭에 저장된 데이터에 대한 metadata를 담고 있는 일종의 구조체이다. Inode는 index node의 줄임말이며, 처음으로 UNIX에서 사용되었다. 이후 이 표현이 굳어져 대부분의 파일 시스템마다 구현은 다를지라도 metadata를 담는 구조체를 inode라고 부르게 되었다.
Inode는 보통 다음 정보를 포함하고 있다.
uid: 파일 소유자의 uidsize: 해당 파일의 크기time: 해당 파일이 마지막으로 접근된 시간ctime: 해당 파일이 처음 생성된 시간mtime: 해당 파일이 마지막으로 수정된 시간mode: 해당 파일에 대한 rwx 권한block: 해당 파일의 데이터가 들어있는 block에 대한 포인터
즉, inode를 읽으면 파일의 정보를 얻을 수 있고 (파일명이 포함되어있지 않다는 점에 유의하자!), inode->block을 읽으면 해당 파일의 데이터가 저장되어있는 위치를 알 수 있는 것이다.
보통 inode는 배열에서 원소에 접근하듯 inode table에서 자신의 인덱스를 사용해 접근되고, 이때 인덱스를 i-number이라 부른다. 예를 들어, 앞서 예시로 든 디스크에서는 i-number가 0부터 79까지 있다고 생각할 수 있다.
그러나 하나의 block 포인터만 가지고 있으면, 해당 파일 시스템은 최대 4KB인 파일만 저장할 수 있을 것이다. 이를 해결하기 위해 block 포인터를 여러 개 만드는 방식을 고려해볼 수 있지만, 너무 많아지면 inode 자체의 크기가 커져 실제 파일 데이터보다 metadata가 커지는 상황이 발생할 수 있다. 이를 해결하기 위해 page table에서 봤던 것처럼 multi-level index를 사용해보는 방식을 고려해볼 수 있다.
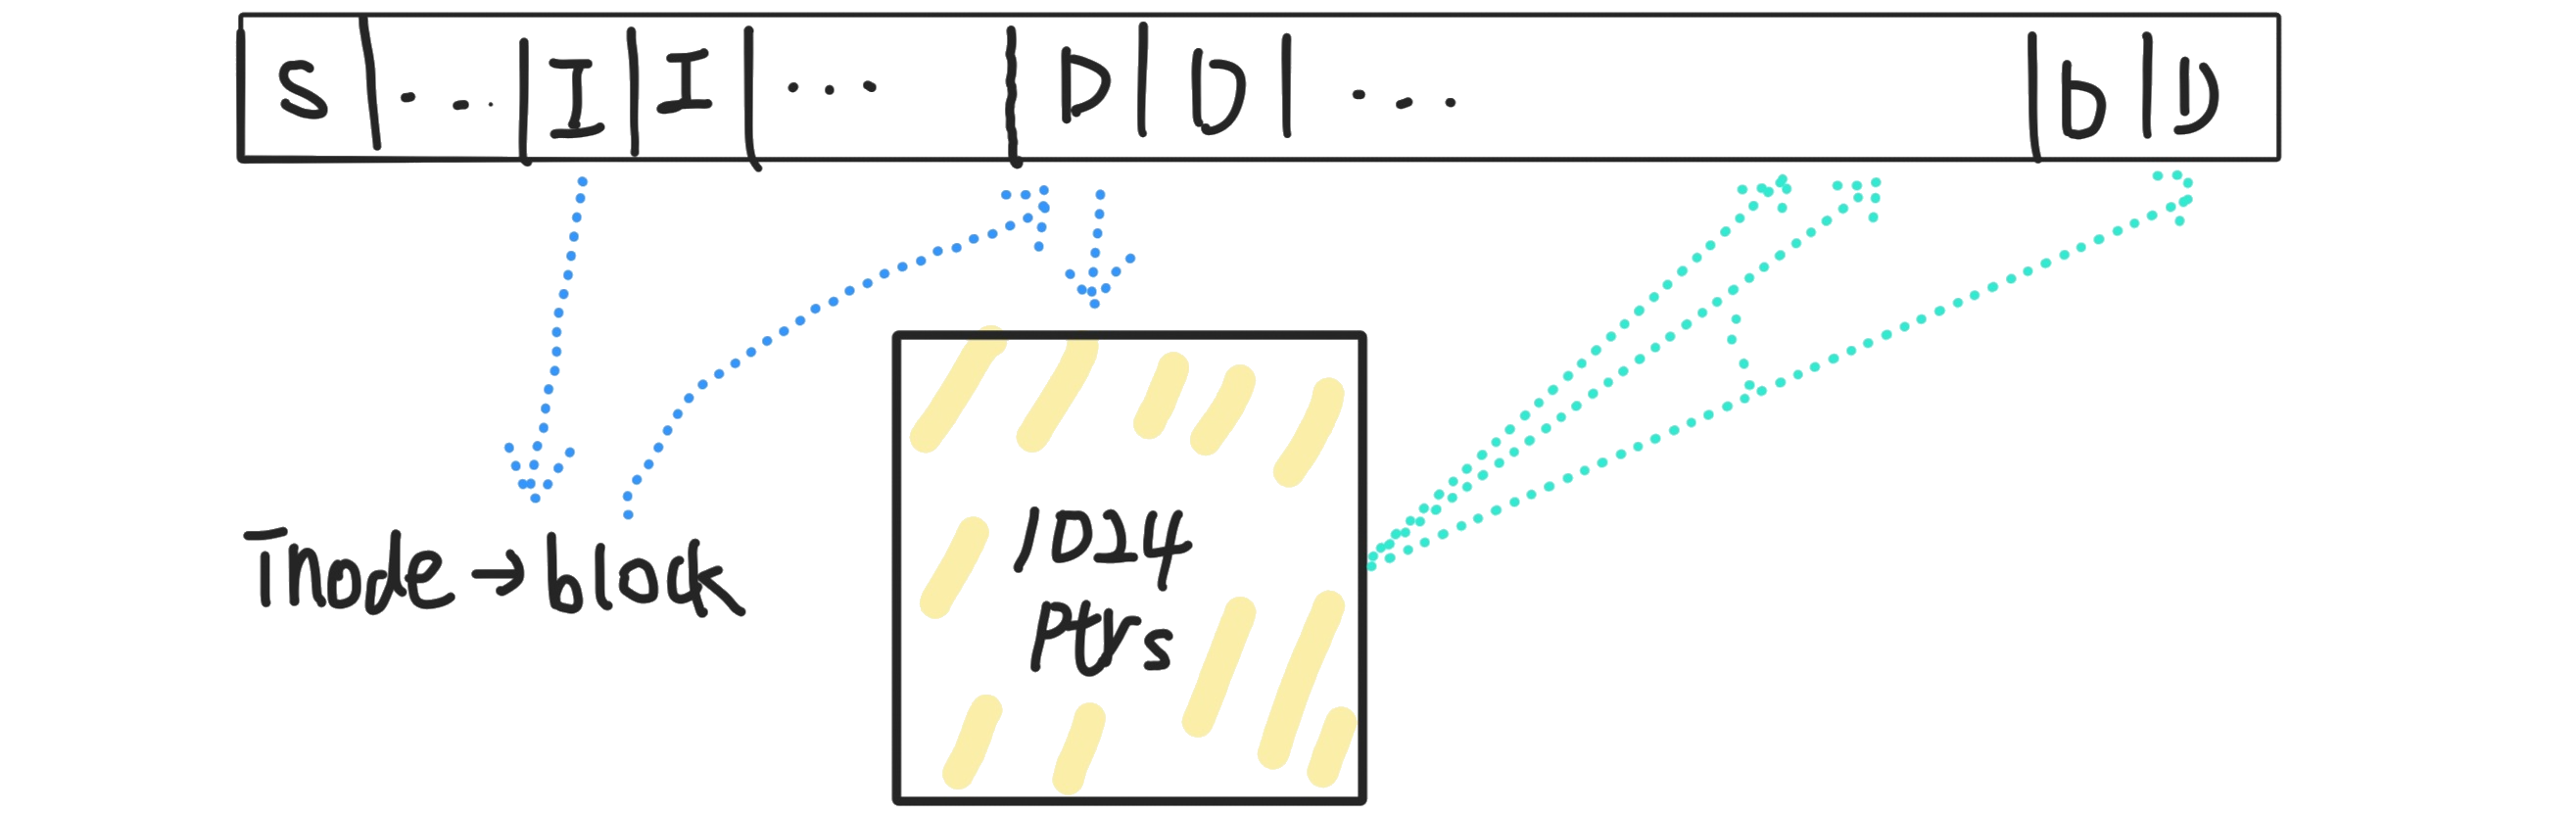
2-level index를 생각해 보자. inode->block은 데이터의 위치를 담고 있는 4KB block을 담고 있을 것이다. 디스크가 4-byte addressing을 사용한다고 가정하면, 한 block에는 1024개의 포인터가 들어갈 수 있다(4KB / 4B = 1024). 각 포인터는 실제로 데이터가 담긴 4KB block을 가리키고 있기 때문에(위 그림을 참고하자) 이 경우, 한 파일의 최대 용량은
일 것이다.
다음으로 3-level index를 생각해 보자. inode->block은 이중 포인터를 담고 있는 4KB block을 담고 있을 것이다. 마찬가지로 이 포인터들은 또 포인터들이 담긴 4KB block을 가리키고 있을 것이고, 마찬가지로 한 파일의 최대 용량은
이러한 방식을 사용하면 쉽게 4-level index의 경우는 $4 \text{ TB}$까지 파일을 저장할 수 있다는 것을 알 수 있다.
참고
이러한 방식은 실제 데이터를 얻기 위해서 disk I/O가 많이 일어나기 때문에,ext4와 같은 파일 시스템은 base-and-bound approach와 비슷한 extent-based approach를 사용한다. 이 방법은 해당 파일의 데이터가 시작되는 block과 몇 개의 block을 사용 중인지 기록해 파일 크기를 유연하게 늘릴 수 있도록 하는 방식이다.
1-3. Directory
앞서 파일이 inode와 data block의 조합으로 이루어지고, inode는 inode table에서 자신의 index인 i-number로 접근된다는 점을 언급했었다. 그러나 inode에는 파일명을 위한 필드는 없는데, 파일명은 directory에 저장되기 때문이다. VSFS에서, directory는 일반 파일처럼 inode와 data block의 조합으로 만들어지지만 data block에 실제 파일의 내용 대신 (i-number, filename) 쌍을 저장해둔다. 예를 들어, 다음과 같은 상황을 가정하자.
$ tree foo --inodes
[8]  foo
├── [12]  bar
│   └── [50]  spam.log
├── [53]  eggs.sh
└── [4]  foobar
이러한 상황에서, foo/의 data block은 다음과 같은 형태를 가지고 있을 것이다.
| inum | strlen | name |
|---|---|---|
| 3 | 2 | . |
| 8 | 3 | .. |
| 12 | 4 | bar |
| 53 | 8 | eggs.sh |
| 4 | 7 | foobar |
여기서 .과 ..은, 각각 현재 directory와 부모 directory를 가리키며, 모든 directory에 존재한다. 마찬가지로 bar/의 data block은 다음과 같은 형태를 가지고 있을 것이다.
| inum | strlen | name |
|---|---|---|
| 12 | 2 | . |
| 3 | 3 | .. |
| 50 | 4 | bar |
foo/와 bar/의 .과 ..이 이름은 같지만 실제로는 서로 다른 inode를 가리키고 있다는 점에 주의해서 보자.
1-4. Access Paths
그렇다면 실제로 어떤 과정을 거쳐 파일에 접근하는지 알아보자. 여기서는 예시를 위해 /foo/bar 파일에 대한 작업을 가정한다.
1-4-1. Create
파일을 만드는 과정은 다음과 같을 것이다.
| time | data bitmap | inode bitmap | root inode | foo inode | bar inode | root data | foo data | bar data |
|---|---|---|---|---|---|---|---|---|
| 1 | read | |||||||
| 2 | read | |||||||
| 3 | read | |||||||
| 4 | read | |||||||
| 5 | read | |||||||
| 6 | write | |||||||
| 7 | write | |||||||
| 8 | write | |||||||
| 9 | write |
이를 시간 순서대로 설명하면 다음과 같다.
- 우선
/에 있는 파일들을 알아보기 위해/의 inode를 읽는다. /inode로부터 data block의 위치를 알아내고, 해당 data block에서foo라는 파일의 inum을 찾는다.- 얻은 inum으로부터
foo/의 inode를 읽어 data block의 위치를 얻는다. - 파일 이름이 겹치는 상황을 막기 위해,
foo/안에bar라는 이름을 가진 파일이 있는지 검사한다. barinode를 만들기 위해 inode bitmap에서 빈 inode를 찾는다.- 해당 inode를 사용중으로 표시한다. 이제 이 inode가
bar의 inode가 된다. foo/의 data 안에bar를 추가한다.barinode를 초기화한다. 이때 소유자, 생성 시각 등이 기록된다.- last modified time등을 수정하기 위해
fooinode에 값을 쓴다.
이렇듯 파일을 만드는 것은, root directory인 /부터 해당 파일이 저장된 directory까지 traverse를 수반한다. 이때 root directory의 inode는 부모가 없기 때문에, superblock등에 기록되거나 항상 같은 inum을 쓰게 해 OS가 접근할 수 있도록 해야 한다.
1-4-2. Open
| time | data bitmap | inode bitmap | root inode | foo inode | bar inode | root data | foo data | bar data |
|---|---|---|---|---|---|---|---|---|
| 1 | read | |||||||
| 2 | read | |||||||
| 3 | read | |||||||
| 4 | read | |||||||
| 5 | read |
- traverse 과정이다
- traverse 과정이다
- traverse 과정이다
foo/의 data block에서bar의 inum을 찾는다.bar의 inode를 읽어 권한 등을 검사한다.
굉장히 간단하기 때문에 설명은 생략한다.
1-4-3. Read
open()된 파일을 읽는 것은 다음과 같다.
| time | data bitmap | inode bitmap | root inode | foo inode | bar inode | root data | foo data | bar data |
|---|---|---|---|---|---|---|---|---|
| 1 | read | |||||||
| 2 | read | |||||||
| 3 | write |
- 앞서 얻은
barinode로부터 data block의 위치를 읽는다. - 해당 data block에서 data를 읽는다.
- last access time등을 수정하기 위해
barinode에 값을 쓴다.
1-4-4. Write
open()된 파일에 쓰는 것은 다음과 같다.
| time | data bitmap | inode bitmap | root inode | foo inode | bar inode | root data | foo data | bar data |
|---|---|---|---|---|---|---|---|---|
| 1 | read | |||||||
| 2 | read | |||||||
| 3 | write | |||||||
| 4 | write | |||||||
| 5 | write |
- 앞서 얻은
barinode로부터 data block의 위치를 읽는다. 여기서는 하나도 없는 경우를 가정한다. - 새로운 data block을 할당하기 위해, 빈 data block을 찾는다.
- 찾은 data block을 사용중으로 표시한다. 이제부터 이 data block은
bar의 data block이 된다. - 해당 data block에 값을 쓴다.
- last access time과 새로 추가된 block 정보 등을 기록하기 위해
barinode에 값을 쓴다.
마찬가지로 간단한 과정이므로 설명은 생략한다.
1-5. Caching / Buffering
앞에서 본 것처럼 파일 하나를 만들거나 여는 데는 굉장히 많은 disk I/O가 수행된다. 특히 파일 경로가 길거나(예를 들어, /a/b/c/d/e/f/g/h/i/.../z/foo.txt) 한 directory 안에 너무 많은 파일이 있다면 traverse 과정에서 굉장히 많은 시간이 들 것이다. 이를 해결하기 위해 메모리 안에 디스크 전용 cache를 마련해 두거나 virtual memory의 page와 cache를 통합시킨 unified memory cache를 도입하기도 했다.
또한, 데이터를 조금 쓴 후 같은 파일에 덧붙여 쓰는 상황에 대비하기 위해 write buffering이라는 방식도 도입됐다. 이 방식은 앞에서 본 non-work-conserving한 방식 중 하나로, write() 요청이 발생했을 때 디스크에 바로 쓰지 않고 조금 기다렸다 다른 요청과 함께 쓰는 방식이다.
2. Fast File System (FFS)
우리가 앞서 살펴본 VSFS는 굉장히 큰 문제점이 있다. 파일에 접근하기 위해서는 inode와 data 영역을 번갈아가면서 접근해야 하는데, 문제는 이 둘이 너무 멀리 떨어져 있어 disk I/O 작업이 거의 random access 수준으로 떨어져버린다는 것이다. 실제로 VSFS가 그대로 적용된 파일 시스템은 최대 읽기 속도의 2%정도의 성능만을 이용할 수 있다는 연구 결과도 있다.
이외에도 다른 문제가 있는데, 우리가 앞서 memory virtualization에서 살펴봤던 fragmentation 문제이다. Data region이 연속된 큰 공간이다 보니 externel fragmentation 문제에 취약할 수밖에 없다. 이를 위해 defragmentation 도구(우리가 사용하는 디스크 조각 모음이 그것이다)들이 개발되었지만, 근본적인 원인을 해결해주지는 못해 일정 주기마다 돌려줘야 했다. 이러한 문제들을 해결하기 위해 FFS가 등장했다.
2-1. Cylinder Group / Layout
FFS는 우선 HDD를 cylinder라는 개념으로 바라본다. 앞선 글에서, 디스크는 여러 장의 platter로 이루어진다고 했었고, 각각의 surface는 여러 개의 track으로 이루어진다 했었다. 여기서 cylinder란 서로 다른 platter상에서 같은 위치에 있는 track을 모아둔 것이라고 생각하면 된다. 또한 cylinder group은 연속된 몇 개의 cylinder를 모아둔 것이다. 아래 그림에서 같은 색으로 표시된 것들이 하나의 cylinder라고 볼 수 있고, 연속된 cylinder를 여러 개 모아 두면 그것이 cylinder group이 된다.
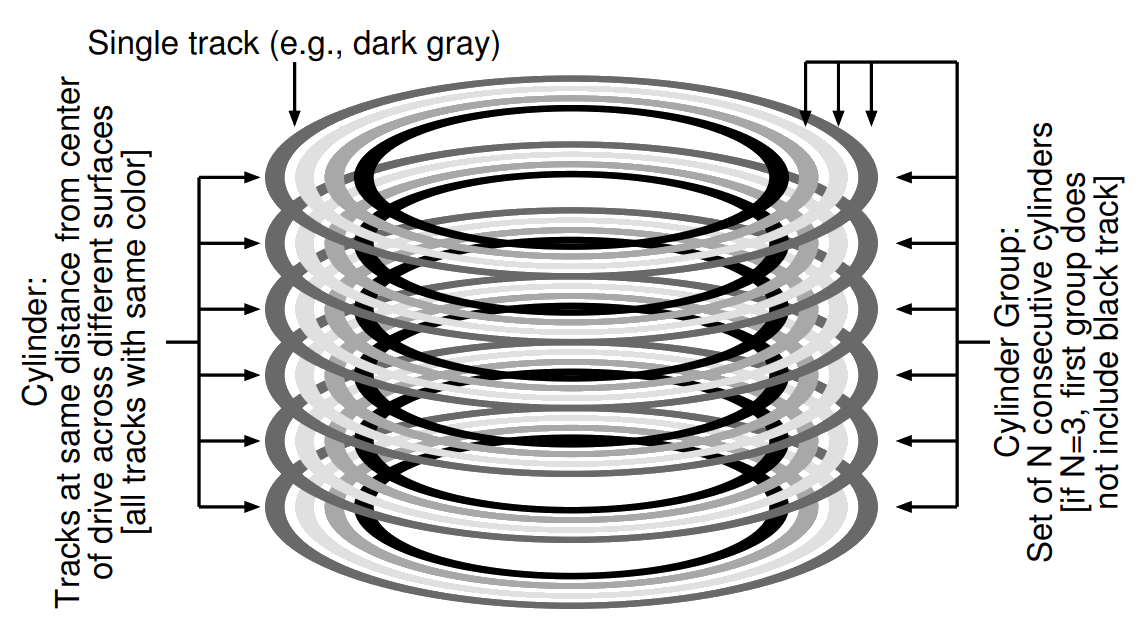
물론 HDD는 자신이 어떻게 구성되었는지를 추상화를 통해 OS로부터 감추기 때문에 OS가 cylinder group을 직접적으로 사용할 수는 없다. 대신, 디스크는 디스크 안의 컨트롤러를 통해 LBA(Logical Block Addressing)을 제공하며, 이는 OS가 디스크 전체를 하나의 1차원 배열처럼 다룰 수 있게 한다. 이때 LBA에서 인접한 주소는 같은 cylinder group에 속할 확률이 크기 때문에, 전체 디스크 블럭을 다음 그림과 같이 연속된 몇 개씩 묶어놓으면 해당 group 안의 블럭들은 같은 cylinder 안에 속할 확률이 크다.
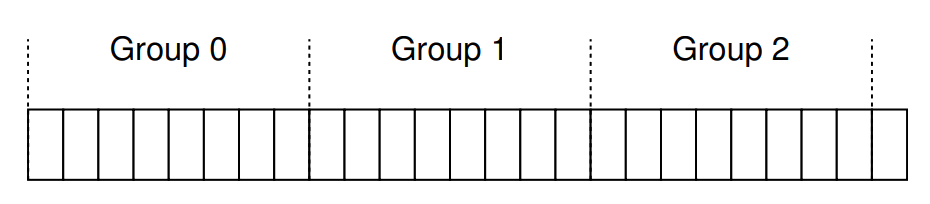
이렇게 나뉘어진 group을
Block Group
라고 한다.
앞서 말했듯, 같은 block group 안의 block들은 같은 cylinder group에 속할 가능성이 크기 때문에, 접근속도도 굉장히 빠르다 (거의 sequential access에 준하는 속도를 낼 수 있을 것이다). 따라서 FFS는 각 group마다 superblock, inode bitmap, data block bitmap, inode, data block들을 두기로 한다. 즉, 다음과 같이 관리한다는 것이다.
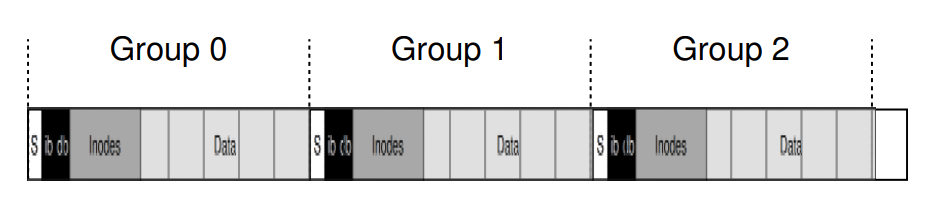
이렇게 하면 inode와 data 접근이 반복적으로 일어나더라도 성능을 유지할 수 있게 된다.
하나 주목할 점은 superblock이 여러 개 있다는 것이다. 각 superblock의 값은 전부 동일하며, 이는 몇 개의 superblock이 손상되어도 다른 group의 superblock 내용을 대신 가져다 쓸 수 있게 해 줘서 파일 시스템의 안정성을 높이는 효과가 있다.
2-2. Policy
앞서 말했듯, 같은 block group 안에서는 disk I/O에 대한 속도가 굉장히 빠르다. 따라서 FFS는 “연관성이 많은 것”을 같은 block group에 속하게 하는 것을 목표로 한다. 다시 말해, 특정한 inode나 data에 접근이 일어났을 때 이후 접근될 가능성이 높은 데이터들을 같은 block group에 배치한다는 것이다.
이를 위해, FFS는 directory와 해당 directory 안의 파일들을 가능한 같은 block group 안에 두려고 노력한다. 예를 들어, 3개의 파일 /a/b, /a/c, /a/d가 있다고 가정하자. 이 경우, a/에 접근하면 a/ 안의 파일들에도 접근할 확률이 매우 높다 (traversing 상황을 생각해보자!). 따라서 a/, b, c, d의 inode와 data는 전부 같은 group에 저장된다. 반면에, e/f와 같은 파일은 당연히 다른 block group에 저장될 것이다. 해당 상황을 간단하게 표현해보면 다음과 같을 것이다.
| # Block Group | Files / Directories |
|---|---|
| 1 | a/, b, c, d |
| 2 | e/, f |
그렇다면 새로운 directory에 대한 block group은 어떤 기준으로 할당될까? FFS는
- 가장 적은 수의 directory를 포함하면서
- 사용되지 않은 inode가 가장 많은 block group
을 새로운 directory와 그 안의 파일들이 저장될 group으로 선정한다. 첫 번째 조건의 이유는 block group간 directory의 비율을 맞추기 위함이다. 이를 맞추지 않는다면 특정 data block에 directory가 집중되면서 해당 directory 안에 파일을 만들 때 공간이 부족해 해당 directory 안의 파일들이 서로 다른 block group에 저장될 위험성이 커진다. 마찬가지로 2번째 조건도 특정 directory 안의 파일들을 최대한 같은 block group에 많이 저장하기 위함이다.
그러나 지금까지 살펴본 방법으로는 block group 크기에 준하는 큰 파일을 저장할 때 효율을 보장할 수 없다. 예를 들어, 한 block group은 3개의 block으로 이루어져 있고, 1개는 inode, 2개는 data로 쓰인다고 하자. 각 block은 8칸으로 이루어져 있다. (여기서 칸은 임의의 자료 단위라고 생각하자). 만약 /a라는 파일의 크기가 13칸이라면, 다음과 같을 것이다.
Inode       Data
/a______    /aaaaaaa aaaaaa__
따라서 a 다음으로 오는 파일은 2칸보다 크기가 작지 않다면 대부분 다른 블럭에 배정될 것이다. 이는 디스크가 / 안의 파일들이 접근할 때 random access에 준하는 속도를 내게 하기 때문에 FFS의 이념과 완벽히 위배된다. 따라서, FFS는 a를 여러 block group에 걸쳐 분산시킴으로써 a를 읽는 속도를 희생하는 대신 다른 파일들이 쓸 공간을 만들어준다. 만약 한 block group당 올 수 있는 한 파일의 최대 크기를 4칸으로 설정했다면 다음과 같을 것이다.
Inode       Data
/a______    /aaaa___ ________
________    aaaa____ ________
________    aaaa____ ________
________    a_______ ________
와 같을 것이다. 이렇게 하면, a에 대한 단일 파일 접근 속도는 낮아지겠지만(여러 block group에 걸쳐 있어 추가적인 seek time이 발생하기 때문에), / 안의 파일들이 /와 같은 block group 안에 저장될 수 있기 때문에 전반적인 파일 접근 속도는 높아질 것이다. 이때, 한 block group 안 최대 단일 파일 크기를 결정하는 것은 “최대 성능의 얼마만큼을 내고 싶냐”에 따라 계산할 수 있다.
예를 들어, 평균 $T_{position} = T{rotation} + T_{seek}$이 $10 \text{ ms}$이며 최대 $40 \text{ MB/s}$로 데이터를 전송하는 디스크를 가정하자. 만약 최대 성능의 50%를 보장하고 싶다면, 다시 말해 $T_{IO}$가 최소한 절반의 $T_{position}$과 $T_{transfer}$로 구성되게 하고 싶다면 우리는 $10 \text{ ms}$동안 해당 디스크가 전송할 수 있는 데이터의 양을 한 칸으로 잡으면 된다. 따라서
\[\frac{40 \text{ MB}}{s} \cdot \frac{1024 \text{ KB}}{1 \text{ MB}} \cdot \frac{1 \text{ s}}{1000 \text {ms}} \cdot 10 \text {ms} = 409.6 \text{ KB}\]임을 간단하게 할 수 있다. 이렇게 계산하는 과정을 상각 (amortization)라고 부른다.
Leave a comment